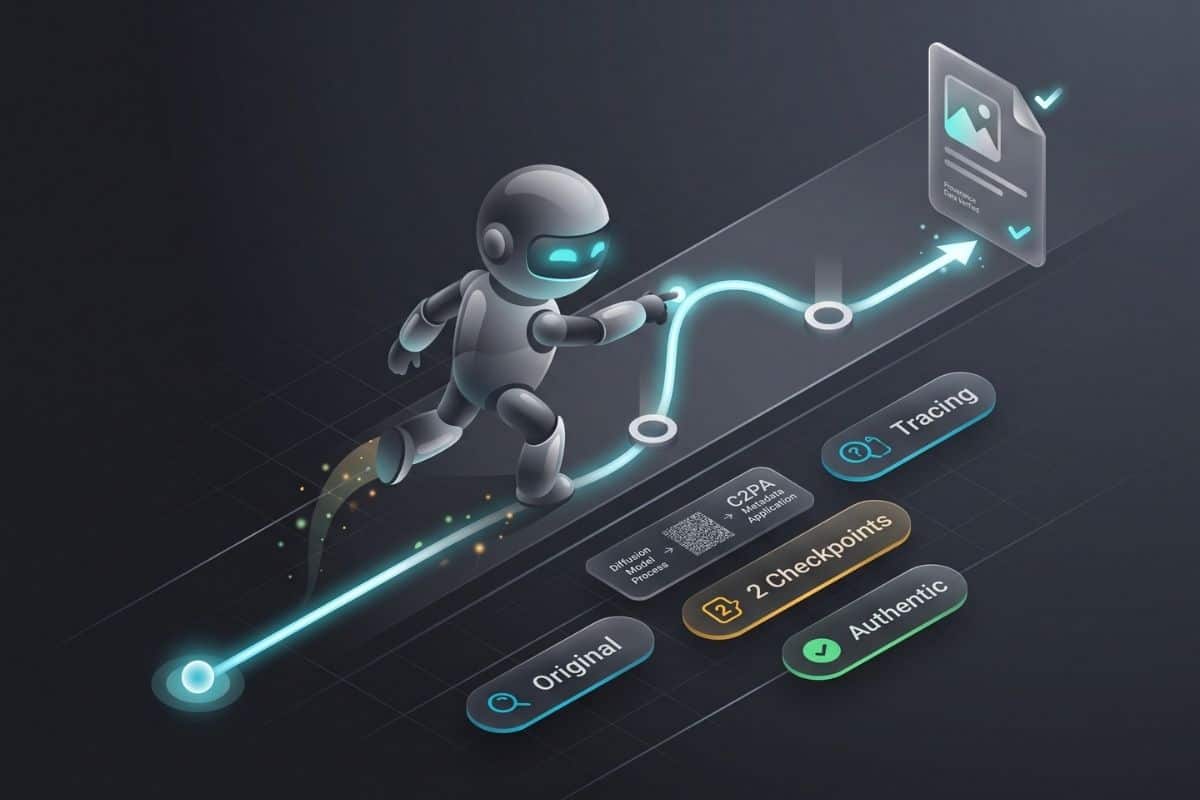
La génération d'images par IA a beaucoup évolué depuis les débuts de DALL·E en 2021, époque où les utilisateurs se contentaient de taper “ chat astronaute ” pour voir apparaître quelque chose d'étrange à l'écran. Aujourd'hui, cette technologie est utilisée au sein des services marketing, des studios de jeux vidéo et des catalogues de commerce en ligne, où elle est mise à contribution quotidiennement dans le cadre d'un véritable travail de production.
Mais qu'est-ce que la génération d'images par IA, exactement ? En termes simples, il s'agit d'un processus d'apprentissage automatique qui transforme une consigne textuelle en une image entièrement nouvelle. Le modèle part d'un bruit aléatoire et l'affine progressivement pour obtenir une image qui correspond à votre description. Pas besoin de pinceau, d'appareil photo ni de photo existante.
On ne saurait trop insister sur l'ampleur du phénomène. Plus de 150 millions de personnes utilisent désormais chaque mois des générateurs d'images basés sur l'IA, produisant environ 80 millions d'images par jour, selon les estimations du secteur pour 2026, avec un marché évalué entre $9 milliards et $15 milliards, selon la méthode de calcul utilisée.
On est bien loin des débuts, lorsque DALL·E mini (rebaptisé par la suite Craiyon) était devenu viral uniquement en tant que générateur de mèmes.
Ce guide explique en détail le fonctionnement de la génération d'images par IA : le processus d'apprentissage, la technique de diffusion sur laquelle reposent la plupart des outils modernes, le paysage actuel des modèles, comment rédiger des consignes efficaces, ce que dit réellement la loi concernant la propriété d'une image générée par l'IA, et comment déterminer si une image a été créée par une machine ou par une personne.
Plongeons dans le vif du sujet.
Principaux enseignements
- Les générateurs d'images basés sur l'IA ne copient pas et ne réalisent pas de collages à partir de photos existantes. Ils créent de nouvelles images pixel par pixel à l'aide d'une technique appelée « diffusion », qu'ils ont apprise à partir de milliards de paires image-texte.
- Les modèles de diffusion ont supplanté les GAN (réseaux génératifs antagonistes) en tant qu'architecture dominante à la base d'outils tels que Midjourney, GPT Image 2 et Stable Diffusion.
- L'Office américain des droits d'auteur et la Cour suprême ont confirmé que les images générées exclusivement par l'IA ne peuvent pas être protégées par le droit d'auteur. Seules une retouche humaine substantielle et un contrôle créatif peuvent changer la donne.
- En 2026, repérer les images générées par l'IA dépendra davantage des normes de métadonnées telles que C2PA et des outils de détection spécialisés que de la présence de “ mains étranges ”, car les modèles actuels gèrent l'anatomie bien mieux qu'auparavant.
- Des outils de détection tels que l’« AI Image Detector » et le « Deepfake Detection » d’Undetectable AI permettent de repérer des traces d’IA invisibles à l’œil nu.
Qu'est-ce que la génération d'images par l'IA ?
La génération d'images par IA consiste à utiliser des modèles d'intelligence artificielle pour créer des visuels originaux à partir d'une consigne textuelle.
Il suffit de saisir une brève description dans un générateur d’images par IA pour qu’un modèle, entraîné sur un énorme ensemble de données d’images, produise une image en quelques secondes. Si vous vous êtes déjà demandé comment générer des images par IA, la procédure à suivre est simple : décrivez ce que vous souhaitez, et le modèle transforme vos mots en image.
Ni pinceau ni appareil photo n'entrent en jeu. Le modèle a été entraîné à partir d'une quantité colossale de photos, de peintures et d'œuvres d'art numérique, et il utilise cet apprentissage pour créer quelque chose de nouveau en fonction de vos instructions. Ce “ nouveau ” peut être tout ce que l'esprit humain est capable d'imaginer, qu'il s'agisse de choses réelles ou inventées.
Ne vous inquiétez plus jamais de la détection de vos messages par l'IA. Undetectable AI peut vous aider :
- Faites apparaître votre écriture assistée par l'IA à l'image de l'homme.
- By-pass tous les principaux outils de détection de l'IA en un seul clic.
- Utilisation AI en toute sécurité et en toute confiance à l'école et au travail.
Demandez “ une ville cyberpunk au coucher du soleil ”, et l’IA génère une image qui n’a jamais existé auparavant. Elle ne se contente pas de puiser dans une banque d’images ni de copier l’œuvre d’un autre artiste. Un générateur d’images par IA fonctionne en interprétant votre consigne et en combinant des motifs visuels appris pour créer une composition originale, plutôt qu’en reproduisant quelque chose qui existe déjà.
La qualité des résultats reste inégale. Parfois, ils sont époustouflants. Parfois, ils sont complètement à côté de la plaque, ce qui est hilarant. Avez-vous déjà demandé à une IA de générer des mains humaines ?? C'était autrefois un moyen fiable de repérer un faux, même si les modèles plus récents ont largement comblé cet écart. Les scènes complexes comportant de nombreuses interactions entre objets peuvent toutefois encore dérouter un modèle et provoquer parfois des anomalies visuelles.
Cette technologie a connu un essor fulgurant dès sa sortie du laboratoire. Lorsque DALL·E a été ouvert au grand public en 2021, son adoption a décollé pratiquement du jour au lendemain.
D'ici la fin de l'année 2022, plus de 1,5 million d'utilisateurs ont créé deux millions d'images par jour à l'aide de DALL-E rien que pour sa version « mini ». Ce chiffre semble presque désuet aujourd’hui. En 2026, plus de 150 millions de personnes utilisent chaque mois des générateurs d’images basés sur l’IA, et le secteur s’est fragmenté en une multitude d’outils spécialisés, chacun étant mieux adapté à une tâche spécifique.
Nous verrons un peu plus loin qui occupe exactement la tête de ce classement.
Comment l'IA utilise l'apprentissage automatique pour créer des images
Le principal moteur de la génération d'images par IA est l'apprentissage automatique, ou « ML » en abrégé.
L'apprentissage automatique est un cadre informatique qui permet à des algorithmes d'apprendre des schémas, de reconnaître des relations et de générer de nouvelles données sans intervention humaine directe notable. Grâce à un apprentissage sur des ensembles de données massifs, les modèles d'apprentissage automatique apprennent, en grande partie de manière autonome, à quoi doivent ressembler les objets, les couleurs et les textures.
Il existe deux techniques principales utilisées pour entraîner ces modèles :
- Apprentissage supervisé : On présente à l'IA des images accompagnées de leurs descriptions, ce qui l'aide à associer des mots à des éléments visuels.
- Apprentissage non supervisé : L'IA apprend en analysant des modèles dans des ensembles massifs de données sans instructions étiquetées par l'homme, en donnant un sens aux informations visuelles par ses propres moyens.
D'un point de vue technique, réseaux neuronaux constituent la technologie sous-jacente. Il s'agit de modèles informatiques qui imitent de manière approximative le fonctionnement du cerveau humain, en traitant les informations par couches successives afin de construire une compréhension du contenu réel d'une image.
Voilà pour les grandes lignes. Voyons maintenant, étape par étape, comment fonctionne concrètement la génération d'images par IA.
Comment fonctionne la génération d'images par l'IA (étape par étape)
Le processus en lui-même n'est pas aussi simple que d'appuyer sur un bouton et de voir la magie opérer. Derrière chaque image générée par l'IA se cache un processus minutieusement structuré.
Voici une vue d'ensemble de la situation.
1. Formation sur des ensembles massifs d'images
Avant qu’un modèle d’IA puisse générer des images, il doit d’abord en voir un grand nombre, souvent des millions voire des milliards, extraites d’Internet. Ces images sont associées à des descriptions textuelles qui aident le modèle à comprendre les liens entre les mots et les éléments visuels.
Lorsqu'il voit “ un golden retriever au pelage duveteux allongé au soleil ”, il apprend que “ duveteux ” fait référence à la texture, que “ doré ” fait référence à la couleur et que “ allongé au soleil ” a une incidence sur la lumière et les ombres.
Cette phase revêt une importance capitale, car la qualité d’un modèle dépend entièrement de celle de ses données d’entraînement. Si l’ensemble de données est déséquilibré, par exemple s’il privilégie l’art occidental ou présente des représentations biaisées de certaines professions, les résultats du modèle refléteront ces biais.
C’est pourquoi les chercheurs s’efforcent sans cesse d’affiner les ensembles de données en termes de diversité et d’équité, afin d’éviter que l’IA ne propose systématiquement des hommes blancs d’âge mûr lorsqu’on lui demande de générer “ un PDG ”.”
2. Utilisation de réseaux neuronaux pour reconnaître des caractéristiques
Une fois que le modèle a ingéré une montagne d'images, il commence à traiter les motifs à l'aide de réseaux neuronaux. Comme il n'est pas pratique de mémoriser des images spécifiques, le modèle les décompose en valeurs numériques, identifie des tendances et attribue des probabilités aux relations.
Il apprend que les guitares sont généralement associées aux mains, que les chats ont souvent des moustaches et que la lumière du soleil projette des ombres douces. Demandez-lui “ un flamant rose portant un haut-de-forme et des lunettes de soleil, dansant sur une plage au coucher du soleil, représenté dans un style aquarelle ”, et il ne trouvera aucune image existante à reproduire.
Au lieu de cela, il reconstitue une image originale à partir de concepts qu’il comprend déjà : flamant rose, haut-de-forme, lunettes de soleil, plage, coucher de soleil, aquarelle.
3. Génération d'images à l'aide de modèles d'IA
À ce stade, le modèle est prêt à créer des images, mais il ne les peint pas coup de pinceau par coup de pinceau comme le ferait un artiste humain. La plupart des outils modernes utilisent un processus appelé “ diffusion ”, dans lequel l'IA apprend à « reconstituer » des images à partir du bruit visuel.
Voici comment cela fonctionne :
- Lors de l'entraînement, les chercheurs ajoutent des couches de bruit aléatoire (comme les parasites sur un vieil écran de télévision) aux images.
- Le modèle apprend à reconnaître l'image masquée sous ce bruit.
- Il inverse ensuite le processus, en éliminant progressivement le bruit jusqu'à ce qu'il récupère une image claire et détaillée.
Au bout d'un certain temps, le modèle devient si performant qu'il n'a plus du tout besoin d'une image d'origine. Lorsque vous saisissez une instruction textuelle, il part d'un bruit aléatoire et l'affine pixel par pixel jusqu'à ce qu'une image entièrement nouvelle apparaisse.
4. Affiner les résultats par une formation itérative
Les images générées par l'IA peuvent être d'un réalisme à couper le souffle, mais le processus n'est pas encore parfait. Il arrive parfois qu'un modèle génère une image qui semble presque correcte, avant que l'on remarque un membre supplémentaire bizarre ou un visage qui semble fondu.
En ce qui concerne plus particulièrement les modèles de diffusion, ce raffinement ne résulte pas d’un affrontement entre deux réseaux. Il s’agit là d’une technique GAN, qui fait l’objet d’une section distincte, abordée dans la section suivante. Au contraire, un modèle de diffusion s’entraîne au fil de millions d’étapes de débruitage, apprenant à chaque fois à prédire et à supprimer le bruit avec un peu plus de précision.
Les chercheurs mettent également en place des boucles de rétroaction avec des humains, en présentant au modèle des exemples de résultats réussis et d'échecs afin qu'il apprenne quels motifs visuels répondent réellement à une consigne.
À chaque cycle d’entraînement, les modèles gagnent en précision dans le traitement des reflets, des textures des tissus et, bien sûr, des mains humaines qui ne ressemblent pas à celles d’une créature surnaturelle effrayante.
Diffusion contre GAN : pourquoi la diffusion l'a emporté
Depuis quelques années, les GAN (réseaux antagonistes génératifs) et les modèles de diffusion se disputaient la première place dans le domaine de la génération d’images par IA. Aujourd’hui, presque tous les principaux outils, de Midjourney à GPT Image 2 en passant par Stable Diffusion, fonctionnent grâce à la diffusion.
Voici pourquoi.
Un GAN fonctionne grâce à deux réseaux neuronaux concurrents :
- A générateur, ce qui génère de nouvelles images
- A discriminateur, qui tente de déterminer si ces images sont authentiques ou falsifiées
Le générateur parvient de mieux en mieux à tromper le discriminateur, tandis que ce dernier devient de plus en plus habile à repérer les faux. Ce bras de fer entre les deux systèmes pousse le générateur à produire des images de plus en plus convaincantes.
[Illustration suggérée : schéma comparatif côte à côte entre l'architecture GAN (boucle générateur-discriminateur) et l'architecture de diffusion (étapes de débruitage de l'image à partir du bruit).]
Une fois entraînés, les GAN sont rapides et capables de produire des images nettes et en haute résolution. Mais leur entraînement est réputé pour être instable. Ils sont sujets au “ mode collapse ”, un phénomène où le générateur trouve une poignée de sorties qui trompent systématiquement le discriminateur et se contente de produire des variations de celles-ci, sacrifiant ainsi la diversité au profit de la fiabilité.
Les modèles de diffusion adoptent une approche totalement différente : ils ajoutent progressivement du bruit aux images d'entraînement et apprennent à inverser ce processus étape par étape, comme nous l'avons vu plus haut.
Ce processus d'affinement progressif est plus lent à exécuter, mais il est bien plus stable lors de l'entraînement et produit des résultats plus variés et plus faciles à maîtriser.
Elle s'adapte également mieux aux ensembles de données plus volumineux et aux modèles plus complexes, ce qui correspond exactement à ce qui a été valorisé ces dernières années dans le domaine de la génération d'images par IA.
C'est grâce à cette combinaison — stabilité, diversité et contrôlabilité — que l'architecture de diffusion s'est imposée comme la norme. Les GAN n'ont pas complètement disparu ; on les retrouve encore dans certaines applications d'upscaling et en temps réel où la vitesse prime sur la flexibilité. Mais pour la génération d'images à usage général, c'est l'architecture de diffusion qui s'est imposée.
Types de modèles de génération d'images par l'IA
En coulisses, les générateurs d'images basés sur l'IA s'appuient sur quelques types de modèles fondamentaux.
Réseaux antagonistes génératifs (GAN) : Deux réseaux neuronaux, un générateur et un discriminateur, s'affrontent jusqu'à ce que le générateur produise des images suffisamment réalistes pour tromper le discriminateur. Cette méthode est encore utilisée pour certaines tâches de photoréalisme et d'upscaling.
Modèles de diffusion: Générer des images en ajoutant progressivement du bruit aux données, puis en apprenant à inverser ce processus. À partir d'un bruit aléatoire, le modèle affine l'image étape par étape, guidé par une consigne textuelle. C'est l'approche dominante à l'origine de la plupart des outils en 2026.
Auto-encodeurs variationnels (VAE) : Encoder des images dans un espace latent compressé, puis les décoder pour les retransformer en images. En effectuant un échantillonnage dans cet espace latent, les VAE génèrent de nouvelles images qui ressemblent aux données d'apprentissage. Souvent utilisées pour des tâches nécessitant un résultat contrôlé et structuré.
Transfert de style neuronal (NST) : Cette fonctionnalité prend deux images existantes, l'une pour le contenu et l'autre pour le style, et les fusionne. NST utilise des réseaux neuronaux profonds pour isoler et combiner les textures, les couleurs et les motifs, produisant ainsi des résultats qui imitent le style d'une œuvre d'art ou d'une esthétique particulière.
Panorama actuel des modèles
Le domaine de la génération d'images par IA n'a plus rien à voir avec ce qu'il était il y a encore dix-huit mois. Craiyon, qui était autrefois un nom connu de tous, n'est plus aujourd'hui qu'une curiosité.
Voici ce qui sera effectivement utilisé en production en 2026.
| Modèle | Meilleur pour | Niveau gratuit | Prix de départ |
|---|---|---|---|
| Midjourney V8.1 | Visuels artistiques et stylisés, images de marque | Non | À partir de $10 par mois |
| Image GPT 2 (OpenAI) | Précision des suggestions, rendu du texte, édition | Oui, à débit limité | À partir de $20 par mois ou API avec facturation au jeton |
| Nano Banana Pro (Google) | Photoréalisme, montage haute fidélité, connaissance du monde | Oui | Entre environ $0,02 et $0,15 par image (API) |
| FLUX.2 (Black Forest Labs) | Photoréalisme, solutions hébergées en interne ou flux de travail via API | Poids disponibles | À partir d'environ $0,03 par image (API) |
| Ideogram 4.0 | Logos, affiches, texte lisible dans les images | Oui, en quantité limitée par jour | À partir de $7 par mois |
| Adobe Firefly | Actifs de données sous licence, couverts par une assurance responsabilité civile commerciale | Oui, crédits limités | Entre environ 1 TP et 7 T10 par mois |
| Stable Diffusion 3.5 | Open source, auto-hébergé, entièrement personnalisable | Illimité, local | Gratuit (frais de calcul uniquement) |
Aucun outil ne se distingue dans tous les domaines. Les professionnels en combinent généralement deux ou trois : un pour la conception, un pour les détails photoréalistes et un pour les touches finales, comme l'augmentation de la résolution ou l'ajout de texte.
(Les prix et les classements évoluent rapidement dans cette catégorie ; considérez ce tableau comme un instantané et prévoyez de le consulter à nouveau tous les quelques mois.)
Comment rédiger une consigne efficace
Le facteur le plus déterminant qui distingue une image générée par l'IA sans intérêt d'une image réellement exploitable n'est pas le modèle, mais la consigne. Quelques habitudes structurelles font une différence notable.
Sujet
Commencez par le sujet principal, en le formulant de manière claire et précise. “ Une femme ” donne un résultat trop générique. “ Une femme d’une soixantaine d’années aux cheveux argentés, portant un manteau en laine ” fournit au modèle des repères concrets sur lesquels s’appuyer.
Style
Précisez le style visuel souhaité : photoréaliste, aquarelle, rendu 3D, illustration vectorielle « plate », film noir. Sans cette précision, la plupart des modèles adoptent par défaut un style d'art numérique assez générique.
Composition
Décrivez le cadrage et l'angle de prise de vue : gros plan, plan large, vue aérienne, règle des tiers. Cela a plus d'importance que la plupart des gens ne le pensent, car cela détermine la partie de la scène que le modèle restitue réellement en détail.
Éclairage
Les effets d'éclairage (heure dorée, lumière crue de studio, lumière douce par temps couvert, lueur des néons) contribuent davantage à créer un effet de réalisme que presque tout autre élément de mise en scène. C'est l'un des moyens les plus rapides de transformer une image plate en une image qui semble avoir été conçue de manière intentionnelle.
Consignes négatives
De nombreux outils vous permettent de préciser ce qu’il faut exclure : les images floues, les doigts superflus, les filigranes, le texte. Les consignes négatives ne corrigent pas tous les défauts, mais elles permettent de réduire les artefacts évidents, en particulier dans les outils qui ont encore du mal à traiter les mains ou les arrière-plans.
Format d'image
Choisissez ce format en fonction de l'emplacement réel de l'image : carré pour les flux des réseaux sociaux, 16:9 pour les bannières et les vignettes vidéo, 9:16 pour les Stories et les Reels. Si vous vous trompez, vous devrez recadrer l'image par la suite et perdrez ainsi le contrôle de la composition.
Graines
Une graine est le motif sonore de départ utilisé par le modèle. Verrouiller une graine vous permet de conserver la même composition de base tout en ajustant d'autres détails de la requête, ce qui s'avère vraiment utile lorsque vous cherchez à explorer un concept spécifique plutôt que de générer quelque chose d'entièrement nouveau à chaque fois.
Applications de la génération d'images par l'IA
Ce qui demandait autrefois des heures de travail manuel de conception peut désormais être réalisé en quelques minutes grâce à la bonne Outils de création de contenu AI.
Créateurs de publicité : Les marques utilisent des générateurs d'images basés sur l'IA pour créer des visuels publicitaires, des rendus de produits et des visuels de campagne à un coût et dans des délais bien inférieurs à ceux des méthodes de conception traditionnelles.
Art : Les artistes et les designers utilisent l'IA pour créer de nouveaux styles, réinterpréter des esthétiques existantes et explorer des concepts visuels auxquels ils n'auraient peut-être pas pensé d'eux-mêmes.
Visuels pour le blog et les réseaux sociaux : Les blogueurs n'ont plus besoin de chercher partout des photos d'archives ni de se contenter d'illustrations génériques. Ils peuvent désormais créer des images personnalisées qui correspondent parfaitement au thème de leur contenu.
Développement de jeux et de mondes virtuels : Les studios ont recours à l'IA pour générer des textures, des concepts de personnages et, de plus en plus, des maquettes d'environnements complets pendant la préproduction.
Photographie de produits pour le commerce électronique : Les marques de mode et de produits créent désormais des visuels mettant en scène des mannequins sur des arrière-plans variés sans avoir recours à une séance photo complète, une évolution qui a permis à certains détaillants d'enregistrer des gains mesurables en termes de taux de conversion.
Droits d'auteur et images générées par l'IA
C'est là que beaucoup d'entreprises commencent à s'inquiéter, et à juste titre. Le cadre juridique s'est en effet considérablement clarifié en 2026, même si ce n'est pas la réponse que tout le monde espérait.
Aux États-Unis, les images générées exclusivement par l'IA ne peuvent pas faire l'objet d'un droit d'auteur. Cela a été confirmé de manière définitive en mars 2026, lorsque la Cour de cassation a refusé d'examiner Thaler c. Perlmutter, confirmant ainsi la position de l'Office des droits d'auteur selon laquelle le droit d'auteur présuppose une création humaine.
Saisissez une instruction, acceptez le résultat tel quel, et cette image ne sera plus protégée par des droits d'auteur. N'importe qui pourra alors légalement la reproduire, la remixer ou la vendre, et vous n'aurez aucun fondement juridique pour l'en empêcher.
Ce principe avait déjà été réaffirmé par le Zarya de l'aube Dans cette affaire, le Bureau américain des droits d'auteur a autorisé une artiste à conserver ses droits d'auteur sur le texte et la mise en page d'un roman graphique qu'elle avait créé avec Midjourney, mais pas sur les images générées par l'IA elles-mêmes, car elle n'avait pas exercé un contrôle créatif suffisant sur ces résultats spécifiques.
Le travail assisté par l'IA, c'est une autre histoire. Si vous modifiez de manière substantielle une image générée par une IA, si vous faites des choix de composition délibérés ou si vous combinez le résultat produit par l'IA avec vos propres éléments originaux, cette contribution humaine peut être protégée par le droit d'auteur.
Une consigne à elle seule, aussi détaillée soit-elle, ne suffit pas à satisfaire à cette exigence. Conserver vos brouillons, vos modifications et vos notes de décision est un moyen pratique de documenter cette contribution au cas où cela s'avérerait nécessaire.
La question des données d'entraînement est un sujet à part, qui fait encore l'objet de débats. La question de savoir si les entreprises spécialisées dans l’intelligence artificielle étaient autorisées, dès le départ, à entraîner leurs modèles à partir d’images et de textes protégés par le droit d’auteur fait toujours l’objet de litiges dans le cadre de plusieurs affaires, notamment des différends opposant Getty Images à Stability AI.
Cette question n'a pas encore été tranchée comme l'a été celle de la paternité de l'œuvre ; il faut donc s'attendre à de nouveaux rebondissements à ce sujet.
Dans un contexte professionnel, la conclusion pratique est simple : si vous avez besoin de détenir la pleine propriété légale d’une image, prévoyez une retouche humaine significative, et ne vous contentez pas d’une consigne bien rédigée ; envisagez également d’utiliser des outils tels qu’Adobe Firefly, qui ont été entraînés sur des données sous licence, si la question de l’indemnisation est importante pour votre cas d’utilisation.
Génération de vidéos par IA
La génération d'images par IA n'était en réalité que le premier acte. Les mêmes techniques de diffusion qui transforment le bruit en une image unique s'étendent désormais dans le temps, générant un mouvement cohérent image par image, et la vidéo générée par IA est devenue le secteur qui connaît la croissance la plus rapide dans le domaine de l'IA générative.
La situation a radicalement changé en 2026. OpenAI a fermé l'application web et l'API de Sora après qu'il est apparu que leur exploitation coûtait bien plus cher que ce qu'elles rapportaient.
À la place, des outils tels que Veo 3.1 de Google, Gen-4.5 de Runway et Kling 3.0 sont désormais les choix par défaut, chacun présentant des atouts différents : Veo pour les clips cinématographiques synchronisés avec le son, Runway pour le contrôle du montage et les flux de production, et Kling pour des itérations rentables à grande échelle.
Pour tous ceux qui utilisent déjà des images générées par l'IA dans leurs processus marketing ou de création de contenu, la vidéo constitue la suite logique, et elle soulève les mêmes questions d'authenticité que la génération d'images, mais avec des enjeux plus importants compte tenu du réalisme acquis par les vidéos synthétiques.
Reconnaître les images générées par l'IA en 2026
Autrefois, pour distinguer les images créées par l’homme de celles générées par l’IA, il suffisait de compter les doigts. Ce conseil est aujourd’hui largement dépassé. Les modèles de la génération actuelle reproduisent si bien les mains, les yeux et les textures complexes que ces anciens indices ne fonctionnent presque plus. Voici ce qui permet encore de les différencier.
Vérification des informations d'identification du contenu (C2PA)
Le signal moderne le plus fiable n'est pas visuel : il s'agit des métadonnées intégrées. La norme C2PA (Coalition for Content Provenance and Authenticity) est désormais utilisée par les principales plateformes, notamment OpenAI, Adobe et les fabricants d'appareils photo, pour associer à une image un enregistrement signé cryptographiquement indiquant quel outil l'a créée ou modifiée.
Vous pouvez vérifier cela à l'aide d'un outil de vérification gratuit, comme celui disponible sur contentcredentials.org, ou d'une extension de navigateur qui le lit automatiquement. Ce n'est pas infaillible (les métadonnées peuvent être supprimées), mais lorsqu'elles sont présentes et intactes, cela constitue un indicateur fiable.
Recherchez les incohérences au niveau de l'éclairage et des reflets
L'IA a encore plus de mal avec la physique qu'avec l'anatomie. Les reflets dans les miroirs ou les vitres peuvent ne pas correspondre à la scène réelle, et les ombres peuvent tomber dans des directions qui n'ont pas de sens compte tenu de la source de lumière visible. Si quelque chose dans l'éclairage vous semble “ bizarre ”, cela vaut la peine d'y jeter un second coup d'œil.
Lancer une recherche d'image inversée
Si vous soupçonnez qu'une image a pu être générée par une IA, essayez d'effectuer une recherche d'image inversée sur Google. Contrairement aux photos de banque d'images ou au contenu généré par les utilisateurs, les images générées par une IA n'ont généralement pas d'origine ailleurs sur le Web. Si une image n'apparaît nulle part ailleurs, c'est un indice, même si cela ne constitue pas une preuve en soi.
Utilisez un outil dédié à la détection de l'IA
Les méthodes manuelles ont leurs limites, et de nombreux détails infimes échappent tout simplement à l'œil humain. C'est là qu'interviennent les détecteurs spécialisés.
Nos IA indétectables Détecteur d'images AI analyse une image à l'aide de l'apprentissage automatique afin de détecter des traces d'IA invisibles à l'œil nu. Il suffit de télécharger la photo, et le détecteur s'occupe du reste.
TruthScan Détecteur d'images AI fonctionne de manière similaire : il analyse les pixels, les textures et les couches de métadonnées afin de repérer les signes subtils d'une manipulation par l'IA que même un œil averti a tendance à ne pas remarquer.
Détecter les marqueurs subtils de l'IA grâce à la détection de Deepfake
Pour des images qui semblent presque trop réelles, en particulier celles mettant en scène des personnes, Undetectable AI propose Détection des deepfakes va encore plus loin en matière de vérification. Il est conçu pour détecter les anomalies d'éclairage, les transitions faciales peu naturelles et les distorsions au niveau des pixels, qui sont pratiquement invisibles à l'œil nu.
Il suffit de télécharger une image ou une vidéo pour obtenir un score d'authenticité ainsi qu'une carte thermique indiquant les zones susceptibles d'avoir été manipulées. Associé à l'outil « AI Image Detector », ce système permet d'effectuer à la fois des vérifications superficielles et des analyses structurelles approfondies, ce qui correspond à peu près au niveau de rigueur d'une vérification manuelle.
L'éthique et le débat sur l'artiste
L'aspect technique de la génération d'images par IA ne représente qu'une partie du tableau. L'autre partie concerne un débat qui reste véritablement en suspens : celui de l'équité vis-à-vis des personnes dont le travail a permis, au départ, d'entraîner ces systèmes.
L'objection principale des artistes est simple : la plupart des grands modèles d'images ont été entraînés à partir de milliards d'images récupérées sur Internet, dont une grande partie est protégée par le droit d'auteur, sans le consentement ni la rémunération des créateurs originaux.
Certains artistes ont constaté que leur style personnel, si particulier, pouvait être reproduit simplement en mentionnant leur nom dans une consigne, ce qui soulève des questions dérangeantes : une signature visuelle personnelle, forgée au fil d'une carrière, peut-elle être assimilée et reproduite par un outil du jour au lendemain ?.
D'un autre côté, les entreprises spécialisées dans l'IA et de nombreux utilisateurs font valoir que ces outils ont véritablement démocratisé la création visuelle, en permettant à des personnes sans formation en design ni budget de produire des œuvres d'aspect professionnel, et que les artistes humains ont toujours appris en étudiant et en s'inspirant des œuvres des autres.
Il n’y a pas de réponse définitive à cette question, ni sur le plan juridique ni sur le plan éthique, et les opinions divergent parmi les personnes sensées. Quoi qu’il en soit, il est intéressant de noter certaines évolutions : certains artistes utilisent désormais des outils de protection tels que Glaze ou Nightshade pour modifier subtilement leurs œuvres de manière à perturber l’apprentissage de l’IA sans pour autant altérer leur apparence aux yeux d’un observateur humain.
Plusieurs plateformes ont également mis en place des paramètres permettant de refuser l'entraînement des modèles (“ do not train ”), même si leur application et leur adoption restent inégales. Rien de tout cela ne résout entièrement la tension sous-jacente, mais c'est dans cette direction que s'oriente le débat.
Questions fréquemment posées
Qu'est-ce que la génération d'images par IA ?
Il s'agit du processus consistant à utiliser un modèle d'apprentissage automatique entraîné pour créer une image originale à partir d'une consigne textuelle, sans recourir à un appareil photo, à une photo existante ou à un dessin manuel.
Comment l'IA parvient-elle concrètement à créer une image à partir d'un texte ?
La plupart des outils modernes utilisent la diffusion : le modèle part d'un bruit visuel aléatoire et l'élimine progressivement, étape par étape, en suivant vos instructions, jusqu'à ce qu'une image cohérente apparaisse.
Les images générées par l'IA sont-elles des copies de photos existantes ?
Non. Le modèle apprend des motifs visuels et des relations au cours de l'entraînement, puis les combine pour créer quelque chose de nouveau. Il ne s'agit pas de copier ou de réaliser un collage à partir d'images sources spécifiques.
Puis-je protéger par le droit d'auteur une image que j'ai créée à l'aide de l'IA ?
Pas si le contenu a été entièrement généré par une IA à partir d'une consigne. Vous pouvez éventuellement faire valoir vos droits d'auteur sur les parties que vous avez vous-même modifiées de manière substantielle et créative.
Quel est le meilleur : Midjourney ou GPT Image 2 ?
Aucun des deux n'est universellement “ meilleur ”. Midjourney a tendance à l'emporter en matière de style artistique, tandis que GPT Image 2 se distingue par la précision de ses prompts et la qualité du rendu textuel. La plupart des professionnels utilisent plusieurs outils en fonction du projet.
Quelle est la différence entre un GAN et un modèle de diffusion ?
Un GAN utilise deux réseaux concurrents (un générateur et un discriminateur) pour améliorer la qualité de l'image. Un modèle de diffusion apprend à inverser, étape par étape, un processus d'ajout de bruit. La diffusion est plus stable à entraîner et domine désormais le domaine.
Pourquoi les images générées par l'IA semblent-elles parfois encore peu réalistes ?
Les scènes complexes comportant de nombreux objets en interaction, des phénomènes physiques inhabituels ou des détails fins (comme c'était le cas autrefois pour les mains) peuvent encore dérouter un modèle, même si la situation s'est considérablement améliorée depuis 2023.
Comment savoir si une image a été créée par une IA ?
Vérifiez les informations d'authenticité C2PA, repérez les incohérences au niveau de l'éclairage ou des reflets, effectuez une recherche d'image inversée et utilisez un détecteur d'images basé sur l'IA dédié pour tout ce que les métadonnées ne permettent pas à elles seules de confirmer.
Est-il légal d'utiliser à des fins commerciales des images générées par l'IA ?
En général, oui, mais les droits de propriété peuvent être limités, car les images générées exclusivement par l'IA ne peuvent pas faire l'objet d'un droit d'auteur. Si vous avez besoin de droits exclusifs, prévoyez un travail d'édition humain significatif ou utilisez un outil entraîné sur des données sous licence.
Qu'est-ce que la C2PA et pourquoi est-elle importante ?
Il s'agit d'une norme technique qui intègre dans une image une mention signée indiquant quel outil l'a créée ou modifiée. Les principales plateformes l'adoptent comme principal moyen de signaler l'intervention de l'IA.
La génération de vidéos par IA est-elle la même technologie que la génération d'images par IA ?
Ce système repose sur les mêmes principes de diffusion, étendus dans le temps pour générer un mouvement cohérent, même si les modèles vidéo introduisent une complexité supplémentaire notable en matière de cohérence et de synchronisation audio.
Les artistes sont-ils rémunérés lorsque leurs œuvres servent à entraîner un modèle d'IA ?
Ce n'est généralement pas le cas, et c'est là le cœur du débat éthique et juridique actuel. Certaines plateformes proposent désormais des options permettant de se désinscrire, même si leur adoption varie considérablement.
Conclusion
La génération d'images par IA n'est plus un concept futuriste. Elle est déjà une réalité, elle évolue rapidement et fait désormais partie intégrante du processus de création de contenu numérique, qu'il s'agisse de créations publicitaires, de ressources de jeux vidéo ou encore du domaine de la modélisation évoqué plus haut.
Comprendre le fonctionnement réel de ces technologies, la diffusion, les données d'entraînement et les aspects juridiques liés à la propriété vous confère un véritable avantage, que ce soit sur le marché du travail ou simplement pour mieux s'y retrouver parmi ce que vous voyez en ligne.
Il est tout aussi important de savoir distinguer les images générées par l'IA de celles créées par l'homme, d'autant plus que les deepfakes et les médias synthétiques ne cessent de contourner la détection de contenu par IA des méthodes qui fonctionnaient autrefois de manière fiable. Cette compétence est tout aussi importante pour repérer les indices d'IA dans vos propres images que pour vérifier celles d'autrui.
Prêt à vérifier un élément visuel avant de le publier ? Essayez IA indétectables Utilisez gratuitement des outils d'analyse d'images par IA et de détection des deepfakes, et obtenez une réponse en quelques secondes.