Ja – und hier ist, wie oft. Unabhängige Tests zeigen, dass KI-Erkennungswerkzeuge von Menschen verfasste Texte fälschlicherweise als gefälscht markieren, und zwar mit einer Rate, die von 1% in der Allgemeinbevölkerung bis zu erstaunlichen 61,3% bei bestimmten Autorengruppen reicht.
Nehmen wir zum Beispiel Marcy, eine Studentin im letzten Studienjahr an einer großen staatlichen Universität, deren Abschlussarbeit als „98%“ – also als KI-generiert – markiert wurde, obwohl sie vollständig von Grund auf neu verfasst worden war. Dadurch wurde ihr Abschluss auf Eis gelegt, bis die Versionshistorie ihre Unschuld bewies.
Man kann mit Fug und Recht behaupten, dass sich die Welt seit der Einführung von ChatGPT im November 2022 verändert hat. KI hält Einzug in nahezu jede Branche und trägt zur rasanten Weiterentwicklung bestehender Technologien bei. Der Einsatz von KI-basierten Tools wie ChatGPT zur Texterstellung ist eine beliebte Methode, um das Potenzial der KI zu nutzen.
Ganz gleich, ob Sie freiberuflicher Autor, Verfasser von Inhalten oder sogar Student sind, KI ist ein leistungsfähiges Werkzeug, das Sie zu Ihrem Arsenal hinzufügen können.
Doch dann kommen KI-Detektoren ins Spiel und verderben den Spaß. Das ist natürlich nur ein Scherz, denn es muss natürlich eine Kontrolle geben, um sicherzustellen, dass KI verantwortungsbewusst und in guter Absicht eingesetzt wird. Website-Betreiber, Schulen und sogar Google selbst nutzen KI-Detektoren, um sicherzustellen, dass wir diese Arbeiten nicht als unsere eigenen ausgeben.
Aber können KI-Detektoren auch falsch liegen? Es sollte nicht überraschen, dass die KI-Technologie auf beiden Seiten der Kluft noch unvollkommen ist.
Diese Detektor-Tools… leiden regelmäßig unter falsch-positiven Testergebnissen. Im Folgenden finden Sie einen umfassenden Leitfaden, in dem erklärt wird, wie KI-Detektoren funktionieren, warum sie versagen, was die Forschung dazu sagt und wie Sie Fehlalarme vermeiden und Ihre authentischen Werke schützen können.
Wichtigste Erkenntnisse
- KI-Detektoren stützen sich auf Wahrscheinlichkeiten und nicht auf eindeutige Beweise. Sie suchen nicht nach digitalen Signaturen oder verstecktem Code. Stattdessen analysieren sie Schwankungen in der Satzlänge und die Vorhersagbarkeit von Wörtern, was dazu führt, dass strukturierte, von Menschen verfasste Texte oft fälschlicherweise als Plagiat markiert werden.
- Die von den Anbietern angegebenen Genauigkeitswerte sind irreführend. Ein Tool, das eine Genauigkeit von 99% verspricht, klingt fast perfekt, doch an einer Universität mit 10.000 Studierenden führt diese Fehlerquote von 1% dazu, dass bei jeder einzelnen Aufgabe 100 Studierende zu Unrecht beschuldigt werden.
- Autoren, deren Muttersprache nicht Englisch ist, sind dem größten Risiko ausgesetzt. Da ESL-Autoren häufig einfache, stark strukturierte Sätze und einen direkten Wortschatz verwenden, interpretieren Erkennungsprogramme ihre authentischen Texte regelmäßig fälschlicherweise als maschinell generierte Texte.
- Selbst OpenAI gelang es nicht, die Erkennung zum Laufen zu bringen. OpenAI stellte seinen offiziellen Textklassifikator ein, nachdem dieser lediglich eine Erfolgsquote von 26% erreicht hatte und regelmäßig authentische Texte von Menschen als synthetisch einstufte.
- Die Versionshistorie ist Ihr bester Schutz. Wenn Sie einen übersichtlichen digitalen Nachweis führen, beispielsweise den Bearbeitungsverlauf in Google Docs oder die Zeitleiste eines Word-Dokuments, verfügen Sie über zeitgestempelte Belege, die beweisen, dass Sie Ihre Arbeit von Grund auf selbst verfasst haben.
Wie funktionieren AI-Detektoren?
KI-Detektoren basieren auf Modellen für natürliche Sprache und Millionen von Datenpunkten, die sowohl aus KI-generierten als auch aus von Menschen verfassten Texten bestehen. Wenn Inhalte von einem KI-Detektor-Tool überprüft werden, vergleicht dieses sie mit diesen Datensätzen und sucht nach vorhersehbaren Mustern in der Syntax, der Wortwahl und der Gesamtstruktur.e des Textes.
Diese Detektoren sind darauf trainiert, Muster zu erkennen und diese sowohl mit KI- als auch mit von Menschen erstellten Mustern zu vergleichen. Beispiele. Die Ergebnisse des KI-Detektors geben lediglich die Wahrscheinlichkeit an, dass der gescannte Inhalt von einer KI generiert wurde – sie stellen keine Garantie dar. KI-Detektoren arbeiten auf der Grundlage von Wahrscheinlichkeiten, ohne dass dafür eindeutige Beweise vorliegen.
Was genau sind das für Muster, nach denen KI-Detektoren suchen? Zwei Konzepte, die für KI-Detektoren eine treibende Kraft darstellen, sind „Burstiness“ und „Perplexity“.
Machen Sie sich nie wieder Sorgen, dass KI Ihre Texte erkennt. Undetectable AI Kann Ihnen helfen:
- Lassen Sie Ihr AI-unterstütztes Schreiben erscheinen menschenähnlich.
- Bypass alle wichtigen KI-Erkennungstools mit nur einem Klick.
- Verwenden Sie AI sicher und zuversichtlich in Schule und Beruf.
Perplexität und Burstiness verstehen
- Ratlosigkeit: Die Perplexität bezieht sich, wie der Name schon sagt, darauf, wie komplex die Sprache ist und wie leicht menschliche Leser dadurch verwirrt werden. Zum Vergleich: KI-generierte Texte sind so vorprogrammiert, dass sie eine geringe Perplexität aufweisen, um den Lesern das Verständnis zu erleichtern. Eine hohe Perplexität deutet auf unerwartete, komplexe Sprachwahlen hin, wie sie für menschliches Denken typisch sind.
- Sprengkraft: Unter „Burstiness“ versteht man die Länge und Komplexität von Sätzen. Wer schon einmal von einer KI generierten Text gelesen hat, dem wird aufgefallen sein, dass dieser mechanisch klingt, da viele Sätze eine ähnliche Länge, Struktur und sogar Zeichensetzung aufweisen. Menschliche Autoren wechseln ganz natürlich zwischen kurzen, prägnanten Aussagen und langen, komplexen Sätzen hin und her, was zu einer hohen „Burstiness“ führt.
Die meisten Detektoren nutzen Algorithmen des maschinellen Lernens, die anhand von Datensätzen trainiert wurden, die sowohl von Menschen verfasste als auch von KI generierte Texte enthalten. Sie lernen, subtile Merkmale zu erkennen, die vermeintlich künstliche Inhalte von authentischen unterscheiden.c Schreiben.
Das Problem? Diese Markierungen sind nicht narrensicher. Menschliche Schrift kann entsprechen manchmal KI-Mustern. Vor allem, wenn Sie klar und prägnant schreiben und sich an die gängigen Grammatikregeln halten.
Einige Detektoren nutzen zudem Reverse-Engineering-Verfahren. Sie versuchen vorherzusagen, was ein KI-Modell bei derselben Eingabe generieren würde. Wenn Ihr Text zu sehr mit diesen Vorhersagen übereinstimmt, werden Sie markiert. Aber die Vorhersage iDas entspricht nicht der Realität. Nur weil eine KI etwas Ähnliches schreiben könnte, heißt das noch lange nicht, dass sie es tatsächlich getan hat.
Wie genau sind KI-Detektoren eigentlich?
Wer sowohl KI-Detektoren schon einmal genutzt hat als auch eigene Inhalte von einem KI-Detektor scannen ließ, weiß, dass diese Tools bei weitem nicht perfekt sind.
Während die Unternehmen höchste Präzision versprechen, zeigen Bewertungen in der Praxis je nach Fachgebiet und Hintergrund des Autors erhebliche Ungenauigkeiten.
| Detektor | Vom Hersteller angegebene Genauigkeit | Vom Hersteller angegebene FP-Rate | Unabhängige Feststellung | Zuletzt getestet |
| Turnitin | 98%–99% | < 1% | Bis zu 41 TP6T FP auf Satzebene; über 601 TP6T FP bei Aufsätzen von Nicht-Muttersprachlern | 2026 |
| GPTZero | 99% | < 1% | Starke Schwankungen bei kurzen Textabschnitten; erhöhte Fehlerquoten bei Fachtexten | 2026 |
| Copyleaks | 99.1% | 0.2% | Verlässt sich auf generischen Text; markiert häufig strukturierte Daten und Tabellen | 2026 |
| Originalität.ai | 99% | 1.5% | Aggressives Bewertungsmodell; erhöhte Falsch-Positiv-Rate bei formellen Geschäftskorrespondenz | 2026 |
| ZeroGPT | Nicht näher bezeichnet | < 2% | Unzuverlässige Basisbewertung; stuft historische Texte und Sachbücher routinemäßig als problematisch ein | 2026 |
| Winston AI | 99.7% | < 1% | Gute Leistungen bei den Standardaufsätzen; höhere Fehlerquoten bei kurzen Texten | 2026 |
Warum die Herstellerpreise und die tatsächlichen Preise voneinander abweichen
Entscheidend für die Leistungsfähigkeit von KI-Detektoren ist, wie gut sie trainiert sind. Sich verändernde KI-Modelle und Algorithmen können dazu führen, dass Detektoren mit veralteten Datensätzen arbeiten, was zu einer Diskrepanz zwischen der Genauigkeit im Labor und der Anwendung in der Praxis führt. Dies wird als „Base-Rate-Problem“ bezeichnet.
Ein Anbieter, der eine Falsch-Positiv-Rate von 1% angibt, klingt in einer kontrollierten Testumgebung äußerst zuverlässig. Wendet man dies jedoch auf die gesamte Universitätsbevölkerung an, sind die Auswirkungen in der Praxis katastrophal.
Eine Falsch-Positiv-Rate von 1% bei einer Kohorte von 10.000 Studierenden bedeutet, dass bei jeder einzelnen Hausarbeit 100 unschuldige Studierende fälschlicherweise der akademischen Unredlichkeit beschuldigt werden. Über ein gesamtes akademisches Jahr hinweg kommt es zu Hunderten von Fehlalarmen, die das Leben der Betroffenen beeinträchtigen.
Was die Forschung tatsächlich zeigt
Untersuchungen bestätigen, dass Fehler bei KI-Detektoren weit verbreitet sind und systematische Verzerrungen aufweisen.
- Studie der Stanford HAI zu Verzerrungen bei ESL (Liang et al., 2023): Forscher der Stanford University testeten sieben gängige KI-Detektoren anhand von Aufsätzen, die von Nicht-Muttersprachlern für die TOEFL-Prüfung verfasst worden waren. Die Studie ergab eine Falsch-Positiv-Rate von 61,3% bei den Aufsätzen von Nicht-Muttersprachlern. Über 97% der von Nicht-Muttersprachlern verfassten Aufsätze wurden von mindestens einem Detektor als KI-generiert markiert, da KI-Detektoren einfache, vorhersehbare Prosa routinemäßig fälschlicherweise als synthetisch einstufen.
- Das Urteil der Vanderbilt University (2023): Angesichts der Tatsache, dass es zu falschen Anschuldigungen kam, hat die Vanderbilt University die KI-Detektor-Funktion in Turnitin deaktiviert. Die Vanderbilt University kam zu dem Schluss, dass selbst eine Falsch-Positiv-Rate von unter 1% bei Zehntausenden von Arbeiten ein akzeptables Risiko birgt, dass unschuldige studentische Arbeiten fälschlicherweise als Plagiat identifiziert werden.
- Universität Chicago / NBER-Studie (Jabarian & Imas, 2025): Eine in Chicago durchgeführte Primärstudie hat gezeigt, dass kommerzielle Tools zwar einfache Open-Source-Modelle übertreffen, jedoch fast alle Systeme bei der Analyse geringfügiger Änderungen, fachlicher Texte oder unkonventioneller Schreibstile hohe Fehlerquoten aufweisen.
OpenAI hat seinen eigenen KI-Detektor abgeschaltet
Selbst die Entwickler von KI sind nicht immer in der Lage, KI zuverlässig zu erkennen. Im Juli 2023 hat OpenAI seinen offiziellen KI-Textklassifikator stillschweigend eingestellt. Das Tool wurde aufgrund seiner geringen Genauigkeit aus dem Verkehr gezogen, da es eine True-Positive-Rate von nur 26% aufwies und häufig von Menschen verfasste Texte fälschlicherweise als synthetisch einstufte.
Wenn OpenAI die von ChatGPT generierten Inhalte nicht zuverlässig erkennen kann, kann auch Software von Drittanbietern keine Gewissheit garantieren.
KI-Schrift zeichnet Spuren der Menschheit
Hier ist etwas, was den meisten Menschen nicht bewusst ist: Von KI verfasste Texte enthalten tatsächlich Spuren menschlicher Kreativität. Jedes KI-Modell wurde anhand von Inhalten trainiert, die von Menschen erstellt wurden. In gewisser Weise sind von KI verfasste Texte nichts anderes als neu zusammengestellte menschliche Gedanken.
Das führt zu einem grundlegenden Problem für Erkennungssysteme. Wo endet menschliches Schreiben und wo beginnt das Schreiben durch KI? Das lDie Grenze ist nicht so klar, wie wir gerne glauben würden.
Wenn Sie ähnliche Formulierungen wie Millionen anderer Autoren verwenden, kopieren Sie sie oder denken Sie nur ähnlich? Wenn eine KI dieselbe Formulierung verwendet, kopiert sie dann oder erzeugt sie etwas Neues?
Die Überschneidung zwischen menschlichem und KI-Schreibstil schafft eine Grauzone, in der eine Erkennung fast unmöglich ist. Gute menschliche Texte und ausgefeilte KI-Ausgaben können praktisch nicht voneinander zu unterscheiden sein.
KI-Modelle sind darauf ausgelegt, menschenähnliche Texte zu erzeugen. Je besser sie diese Aufgabe meistern, desto schwieriger wird es,die erkannt werden können.
Die sechs Faktoren, die ein falsch positives Ergebnis auslösen
Der KI-Detektor selbst merkt nicht, dass er einen Fehlalarm auslöst. KI-Detektoren verstehen eigentlich nicht, worüber Sie schreiben, sondern betrachten lediglich oberflächliche Muster, ohne den Sinn oder den Kontext zu erfassen.
Hier sind sechs spezifische Merkmale im Schreibstil, die zu Fehlalarmen führen:
1. Formeller akademischer Sprachgebrauch
Das Schreiben in einem formellen, objektiven Tonfall vermeidet umgangssprachliche Ausdrucksweisen und reduziert die Verwirrung auf rein mechanische Ebenen.
- Beispiel: “Die im Rahmen der Studie gesammelten empirischen Daten deuten auf einen statistisch signifikanten Zusammenhang zwischen der Schlafdauer und der kognitiven Leistungsfähigkeit hin.”
2. Einheitliche Satzlänge
Das Verfassen mehrerer Sätze mit einheitlicher Wortanzahl erzeugt einen gleichmäßigen Rhythmus, den Algorithmen als mechanische Burstigkeit interpretieren.
- Beispiel: “Das Forschungsteam hat die Kennzahlen gründlich geprüft. Die Abteilungsleiter haben sich getroffen, um den Haushalt zu analysieren. Die Führungskräfte haben die Mittelzuweisungen genehmigt.”
3. Fach- oder Rechtsbegriffe
Fachgebiete mit streng standardisierter Sprache zwingen Autoren zu repetitiven Formulierungen, die statistischen Vorhersagemodellen entsprechen. Ein Detektor könnte ein technisches Handbuch oder ein juristisches Dokument bereits allein deshalb als verdächtig markieren, weil es der Standardformatierung und den Standardbegriffen folgt.
- Beispiel: “Der Lizenznehmer verpflichtet sich, den Lizenzgeber von jeglicher Haftung freizustellen, ihn zu verteidigen und schadlos zu halten, die sich aus betrieblichen Ansprüchen Dritter ergibt.”
4. Gängige Formulierungen und Klischees
Die Verwendung von Standardübergängen oder gängigen Redewendungen erhöht die Wahrscheinlichkeit der Wortvorhersage.
- Beispiel: “Letztendlich werden uns diese proaktiven Maßnahmen ermöglichen, wirklich etwas zu bewirken.”
5. ESL-Schreibmuster
KI-Detektoren neigen stark dazu, Folgendes zu erkennen nicht muttersprachliche englische Schrift als KI-generiert denn Nicht-Muttersprachler erzielen niedrige Perplexity-Werte, da sie einfache Sätze und eine direkte Ausdrucksweise verwenden.
- Beispiel: “Außerdem sind viele Studierende der Meinung, dass Online-Studien besser sind, weil sie Zeit sparen und die Fahrtkosten senken.”
6. Stark strukturierte Formate
Dokumente, die sich an starre Vorlagen halten, wie beispielsweise Laborberichte oder Schritt-für-Schritt-Anleitungen, spiegeln naturgemäß die Anweisungsformate von LLMs wider.
- Beispiel: “Schritt 1: Packen Sie die Hardware aus. Schritt 2: Schließen Sie das Netzteil an. Schritt 3: Halten Sie den Netzschalter drei Sekunden lang gedrückt.”
Detektor für Detektor: Bekannte Schwachstellen
Verschiedene Erkennungsmodule verwenden jeweils eigene Bewertungsalgorithmen, was zu spezifischen betrieblichen Schwachstellen führt:
- Turnitin: Äußerst sensibel gegenüber formaler akademischer Syntax, standardisierten Zitierweisen und für Nicht-Muttersprachler untypischen englischen Satzstrukturen.
- GPTZero: Der Schwerpunkt liegt stark auf Metriken zur Perplexität und Burstiness; prägnante technische Dokumentationen, Zusammenfassungen und erklärende Sachtexte werden regelmäßig hervorgehoben.
- Copyleaks: Reagiert empfindlich auf strukturierte Formatierungen; markiert häufig tabellarische Daten, Aufzählungslisten und Inline-Code-Schnipsel.
- Originalität.ai: Entwickelt mit strengen Schwellenwerten für Web-Publisher; neigt zu Fehlalarmen bei ausgefeilten, suchmaschinenoptimierten Marketinginhalten.
- ZeroGPT: Weist eine inkonsistente Bewertungslogik auf; stuft häufig historische Texte, klassische Literatur und offizielle Regierungsberichte als problematisch ein.
Wie man auf einen falschen Vorwurf bezüglich KI reagiert
Zu Unrecht beschuldigt zu werden, KI eingesetzt zu haben, kann verheerende Folgen haben. Aber keine Panik. Falls Ihr von Menschen verfasster Text als KI-Text markiert wird, sollten Sie genau die folgenden Schritte befolgen:
- Dokumentieren Sie Ihren Schreibprozess: Bevor Sie irgendetwas ändern, sammeln Sie Ihre Belege. Suchen Sie nach frühen Entwürfen, Forschungsnotizen, Brainstorming-Ergebnissen und frühen Entwurfsversionen.
- Fordern Sie den aktuellen Bericht und die Punktzahl an: Fordern Sie den vollständigen Bericht der Scan-Software an, um die konkret markierten Passagen und die Gesamtbewertung einzusehen.
- Erkundigen Sie sich nach den Werkzeugspezifikationen und Fehlerquoten: Fragen Sie nach, welcher Detektor konkret verwendet wurde, und lassen Sie sich die dokumentierten Fehlergrenzen sowie die bekannten Falsch-Positiv-Raten mitteilen.
- Informieren Sie sich über das Widerspruchsverfahren: Informieren Sie sich über die offiziellen Richtlinien Ihrer Schule oder Ihres Arbeitgebers zur akademischen oder beruflichen Integrität, um Ihre Rechte zu kennen.
- Verstärken Sie Ihre Verteidigung schriftlich: Reichen Sie eine schriftliche Stellungnahme ein, der Sie Ihren Beweisentwurf beifügen und in der Sie dokumentierte technische Mängel im Zusammenhang mit den Erkennungsalgorithmen hervorheben.
Sobald Sie diese administrativen Schritte erledigt haben, können Sie Ihren Text überprüfen, um sicherzustellen, dass zukünftige Entwürfe authentisch klingen.
Anstatt Inhalte einfach nur zu melden, Unerkennbare KI-Werkzeuge Liefern Sie eine detaillierte Analyse, warum bestimmte Passagen möglicherweise eine Erkennung auslösen, damit Sie die konkreten Elemente verstehen, die Probleme verursachen.
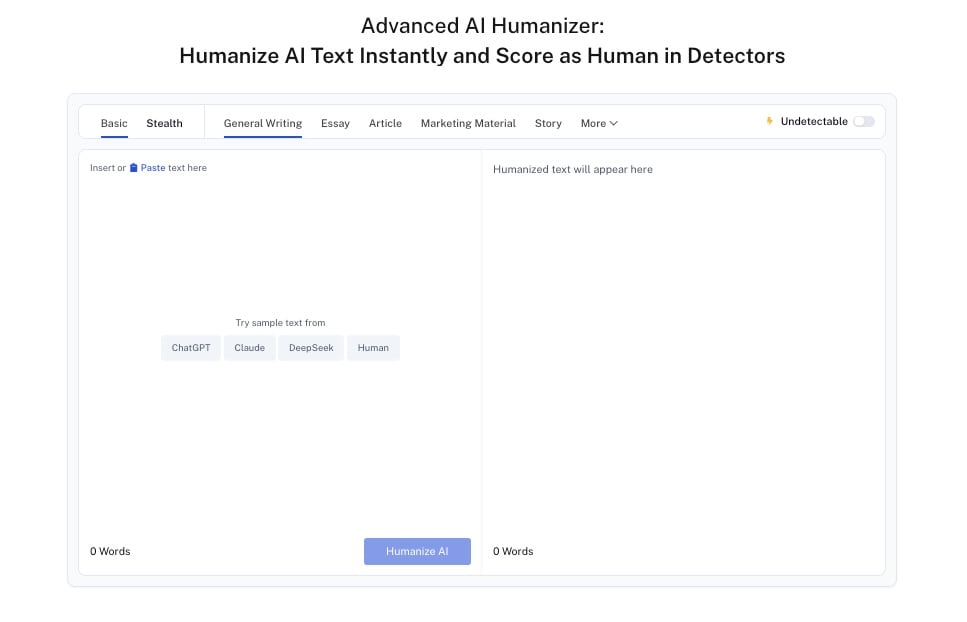
Sie können den markierten Text durch den AI Humanizer um Satzbau, Tonfall und Wortwahl so anzupassen, dass sie dem natürlichen menschlichen Schreibstil entsprechen, ohne dabei Ihre Kernaussage zu verändern.
Beweise, die Sie schützen, bevor Sie beschuldigt werden
Das Anlegen einer digitalen Dokumentenkette während des Schreibens ist der wirksamste Schutz vor falschen Anschuldigungen:
- Versionsverlauf von Google Docs: Erstellt eine fortlaufende, mit Zeitstempeln versehene Aufzeichnung Ihrer Tastenanschläge, Änderungen und der Schreibdauer im Zeitverlauf.
- Zeitleiste zur Bearbeitung in Microsoft Word: Aktiviert interne Nachverfolgungseigenschaften, die die Gesamtbearbeitungszeit und den Änderungsverlauf in den Metadaten des Dokuments erfassen.
- Entwürfe mit Versionsverlauf: Speichern Sie in wichtigen Phasen unterschiedliche Dateiversionen (z. B.,
Entwurf_1.docx,Entwurf_2.docx) sowie aufgezeichnete Bildschirmsitzungen bei Projekten mit hohem Risiko.
Wie man AI-Erkennung vermeidet
Das Publikum und Suchmaschinen werden immer schlauer, und das bedeutet, dass sie merken, wenn etwas nicht stimmt.
Abgesehen davon, dass Sie auf falsche Anschuldigungen reagieren, können Sie proaktive Maßnahmen ergreifen, um das Risiko zu verringern, dass Ihr Text als von einer KI verfasst gekennzeichnet wird, bevor Sie ihn einreichen.
- Verleihen Sie dem Ganzen Ihre ganz eigene Note und Ihren eigenen Stil: Ein allgemeiner Schreibstil löst Detektoren häufiger aus als ein unverwechselbarer Schreibstil. Entwickeln Sie Ihren persönlichen Stil und setzen Sie darauf. Verwenden Sie konkrete Beispiele aus Ihrer eigenen Erfahrung, beziehen Sie sich auf persönliche Anekdoten und bauen Sie kulturelle Bezüge ein, die Ihnen wichtig sind.
- Variieren Sie Ihre Satzstruktur: Kombiniere kurze, prägnante Sätze mit längeren, fließenden Sätzen. Brich bewusst einige Grammatikregeln, um eine bestimmte Wirkung zu erzielen. Füge gelegentlich kleine Eigenheiten hinzu, indem du Sätze beispielsweise mit “Und” oder “Aber” beginnst. Diese menschlichen Akzente tragen dazu bei, deinem Text Authentizität zu verleihen.
- Unvollkommenheit akzeptieren: Echte menschliche Texte weisen kleine Unstimmigkeiten und geringfügige Fehler auf. Übermäßig ausgefeilte Prosa kann sogar Erkennungssysteme auslösen.
- Scannen Sie Ihre fertige Arbeit ein: Überprüfen Sie Ihren Text im Rahmen Ihres üblichen Korrekturprozesses stets, bevor Sie ihn einreichen. Achten Sie besonders auf technische Abschnitte, Einleitungen und Schlussfolgerungen, da diese Bereiche häufig zu Fehlalarmen führen, da sie vorhersehbaren Mustern folgen.
Falsch-negative Ergebnisse: Die andere Seite des Problems
Während Fehlalarme für Autoren ernsthafte Probleme verursachen, treten Fehlentscheidungen auf, wenn KI-Inhalte unentdeckt durchrutschen.
Falsch-negative Ergebnisse treten häufig auf, da bereits geringfügige Änderungen den algorithmischen Musterabgleich zunichte machen. Zu den Methoden, mit denen sich Detektoren umgehen lassen, gehören:
- Einfügen kleiner Tippfehler, überflüssiger Leerzeichen oder abweichender Zeichensetzung.
- Ein LLM dazu anleiten, unter Verwendung benutzerdefinierter Tonfallprofile oder umgangssprachlicher Ausdrücke zu schreiben.
- Die Ausgabe der Maschine durch Paraphrasierungs-Tools oder mehrsprachige Übersetzungsprogramme laufen lassen.
Sowohl falsch-positive als auch falsch-negative Ergebnisse zeigen, dass KI-Detektoren probabilistische Schätzungen sind und keinen eindeutigen Beweis für Betrug darstellen.
Wie sich die KI-Erkennung verändern wird
Da die einfache statistische Mustererkennung an ihre Grenzen stößt, verlagert sich der Fokus in der Branche zunehmend auf prozessbasierte Standards:
- Kryptografische Wasserzeichen: Modellentwickler erforschen Techniken, um unsichtbare statistische Wasserzeichen direkt auf der Generierungsebene in KI-Ergebnisse einzubetten.
- C2PA und Herkunftsstandards: Protokolle zur Herkunftsnachverfolgung digitaler Inhalte werden erweitert, um die Entstehung von Texten ab dem Zeitpunkt der Eingabe über die Tastatur zu verfolgen und so nachprüfbare Aufzeichnungen über die ursprüngliche Herkunft zu erstellen.
- Tastenanschlag- und Prozessüberprüfung: Akademische Plattformen verzichten zunehmend auf das nachträgliche Scannen von Texten und erfassen stattdessen in Echtzeit Tastenanschläge, Bearbeitungsdauer und Überarbeitungsgewohnheiten direkt in den Schreibprogrammen.
Glossar
- Ratlosigkeit: Ein Maß für die Zufälligkeit einer Sprache; eine geringere Perplexität deutet auf vorhersehbare Wortwahlen hin.
- Sprengkraft: Die Vielfalt hinsichtlich Satzlänge, Satzbau und Rhythmus innerhalb eines schriftlichen Textes.
- Falsch-positiv: Ein Fehler, bei dem echte menschliche Texte fälschlicherweise als von einer KI generiert eingestuft werden.
- Falsch-negatives Ergebnis: Ein Fehler, bei dem von einer KI generierter Text die Erkennung umgeht und als von einem Menschen verfasst eingestuft wird.
- Der Irrtum der Basisrate: Ein statistischer Fehler, bei dem geringe Grundfehlerquoten in großen Grundgesamtheiten zu einer enormen Anzahl absoluter Fehler führen.
- Wasserzeichen: Einbetten versteckter kryptografischer Marker in die Maschinenausgabe, um deren Herkunft zu überprüfen.
- Fingerabdruck: Analyse individueller Schreibgewohnheiten, der Wortwahl und stilistischer Merkmale zur Zuordnung der Urheberschaft.
Häufig gestellte Fragen
Kann Turnitin ChatGPT erkennen?
Turnitin sucht nach strukturellen Mustern, die mit großen Sprachmodellen (LLMs) in Verbindung stehen. Da das System jedoch auf Wahrscheinlichkeiten basiert und keine direkte digitale Nachverfolgung durchführt, ist es anfällig für Fehlalarme.
Ist ein AI-Score von 100% ein Beweis für Betrug?
Nein. KI-Werte spiegeln statistische Wahrscheinlichkeiten wider, die auf Mustererkennung beruhen, und stellen keinen digitalen Nachweis für Fehlverhalten dar. Hohe Werte treten regelmäßig bei formellen, technischen oder nicht muttersprachlichen englischen Dokumenten auf.
Kann ich allein aufgrund meiner Detektor-Punktzahl ausgeschlossen werden?
Die meisten großen Universitäten verbieten Disziplinarmaßnahmen, die ausschließlich auf den Ergebnissen automatisierter Erkennungssysteme beruhen, da nachweislich Fehlalarme auftreten und rechtliche Haftungsrisiken bestehen.
Werden Grammatikfehler von Grammarly markiert?
Ja. Die erweiterten Autovervollständigungsvorschläge, Tonfallanpassungen und die Umformulierung ganzer Sätze in Grammarly verändern die Komplexität und die Burstiness des Textes, was dazu führt, dass von Menschen verfasste Entwürfe KI-Warnungen auslösen.
Funktionieren sie auch bei umformulierten Texten?
Die Erkennungsgenauigkeit nimmt erheblich ab, wenn der Text von einem menschlichen Verfasser umformuliert, umgestellt oder bearbeitet wird, da eine veränderte Syntax den Musterabgleich stört.
Sind sie gegenüber ESL-Autoren voreingenommen?
Ja. In Fachzeitschriften veröffentlichte Studien bestätigen, dass nicht-muttersprachliche Englischschreiber aufgrund ihres begrenzten Wortschatzes und ihrer formalen Satzstrukturen Falsch-Positiv-Raten von über 60% aufweisen.
Warum kommen zwei Detektoren bei demselben Text zu unterschiedlichen Ergebnissen?
Verschiedene Anbieter von Erkennungssoftware verwenden proprietäre Trainingsdatensätze, unterschiedliche Bewertungsschwellenwerte und individuelle algorithmische Gewichtungen.
Kann ich gegen einen falschen Erkennungsbericht Einspruch einlegen?
Ja. Sie können Einspruch einlegen, indem Sie Versionsverläufe, mit Zeitstempeln versehene Gliederungen, Forschungsnotizen und Dokumentmetadaten vorlegen, die Ihren schrittweisen Schreibprozess belegen.
Funktionieren KI-Detektoren bei Code?
Nein. Programmiersprachen basieren auf einer starren Syntax und standardisierten Funktionen, was dazu führt, dass Erkennungssysteme von Menschen geschriebenen Code häufig fälschlicherweise als maschinengeneriert einstufen.
Funktionieren sie auch bei nicht-englischen Texten?
Die Erkennungsgenauigkeit nimmt bei nicht-englischen Inhalten deutlich ab, da die meisten kommerziellen Erkennungsprogramme überwiegend anhand englischer Datensätze trainiert wurden.
Wie viel Text müssen Detektoren analysieren?
Die meisten Engines benötigen mindestens 100 bis 250 Wörter, um stabile probabilistische Metriken zu berechnen. Kurze Textabschnitte führen zu äußerst unzuverlässigen Ergebnissen.
Führt das Bearbeiten von KI-Text zu einer niedrigeren Punktzahl?
Ja. Durch unterschiedliche Satzlängen, die Abwechslung sich wiederholender Vokabeln und das Einbringen persönlicher Anekdoten werden die einheitlichen Muster durchbrochen, nach denen die Erkennungsalgorithmen suchen.
Mit AI-Detektoren navigieren, ohne den Verstand zu verlieren
Können sich KI-Detektoren also irren? Ja, natürlich. Sind KI-Detektoren fehlerhaft? Auf jeden Fall. Funktionieren KI-Detektoren? Meistens tun sie das.
Es ist nicht ungewöhnlich, dass Menschen nur in Schwarz-Weiß-Kategorien denken, doch ein KI-Detektor kann sowohl Mängel aufweisen als auch seinen Zweck erfüllen. Wenn ein KI-Detektor richtig eingesetzt wird, kann er einen Schutz vor dem unethischen Einsatz von KI in der Wissenschaft und bei der Erstellung von Inhalten bieten. Wenn KI-Detektoren jedoch Fehlalarme auslösen und von Menschen verfasste Texte fälschlicherweise als KI-geschrieben kennzeichnen, dann haben wir ein Problem.
Wir dürfen nicht vergessen, dass wir auf dem Weg zur generativen KI noch ganz am Anfang stehen. Die Technologie, über die wir heute verfügen, wird in fünf oder zehn Jahren veraltet wirken. Da sich die KI-Technologie weiterentwickeltJe besser diese werden, desto genauer werden auch die KI-Detektoren.
Bis dahin müssen wir uns damit abfinden, dass diese Erkennungssysteme bei weitem nicht perfekt sind und dass ein KI-Erkennungswert niemals als schlüssiger Beweis für Betrug oder wissenschaftliche Unredlichkeit herangezogen werden sollte.
Wenn Sie sicherstellen möchten, dass Ihre von Menschen verfassten Inhalte authentisch bleiben und nicht falsch klassifiziert werden, bewahren Sie Ihren eigenen Stil, schreiben Sie authentisch und lassen Sie Ihrer Kreativität freien Lauf.
Versuchen Sie Nicht nachweisbare AI Nutzen Sie noch heute diese Möglichkeit, um markierten Text in einen natürlich und authentisch klingenden, menschenähnlichen Text umzuwandeln und Ihre Arbeit selbstbewusst zu verteidigen.