Wouldn’t it be nice to have a chatbot for your business? Something that runs round-the-clock on your website so you don’t miss possible customers in the wee hours of the night?
Un rapporto del 2025 ha rilevato che acquirenti nottambuli generano il maggior fatturato nonostante rappresentino solo una piccola parte della navigazione totale, dimostrando quanto possa essere prezioso il traffico notturno.
Well, it’s time to learn how to train AI. With the right training, your personalized AI model will be able to analyze customer data, predict what you need, and give fast and accurate responses.
But this isn’t just for businesses to take advantage of. AI has made an impatto sui posti di lavoro in tutti i settori, utilizzando l'apprendimento automatico per semplificare le attività e migliorare il processo decisionale con dati affidabili.
Whether you’re a business owner looking to improve your operations or a researcher who wants to push the limits of today’s tech, knowing how AI works is definitely beneficial.
Here’s our guide on how to train an AI model to make it your powerful asset.
Immergiamoci!
Punti di forza
-
L'addestramento di un modello di IA comporta l'inserimento di grandi set di dati di alta qualità affinché possa apprendere modelli, effettuare previsioni e migliorare la precisione nel tempo.
-
Il processo comprende diverse fasi fondamentali: raccolta dei dati, pulizia, etichettatura, aumento, suddivisione, bilanciamento, protezione della privacy, messa a punto, valutazione e implementazione.
-
Dati puliti, imparziali e sicuri sono fondamentali per garantire modelli di IA equi e affidabili in grado di funzionare con precisione nelle applicazioni del mondo reale.
-
Il monitoraggio continuo dopo l'implementazione previene la deriva dei dati e il calo delle prestazioni, mantenendo il modello efficiente e affidabile.
-
Strumenti come Undetectable AI possono perfezionare e umanizzare i contenuti generati dall'intelligenza artificiale durante tutto il processo di formazione, garantendo che i risultati siano naturali, etici ed efficaci per l'uso nel mondo reale.
Che cos'è la formazione AI e perché è importante?
L'addestramento dell'intelligenza artificiale è proprio quello che sembra: il processo di addestramento di un modello di apprendimento automatico. Con il vostro aiuto, può imparare a riconoscere schemi, fare previsioni o eseguire compiti specifici.
L'addestramento consiste nel fornire al sistema di intelligenza artificiale una grande quantità di dati rilevanti. Il modello analizza questi dati e impara da essi. Possiamo quindi aspettarci che le sue prestazioni migliorino nel tempo.
The better the quality of data that’s used during training, the more accurate and effective the AI model will be.
Non preoccupatevi più che l'intelligenza artificiale rilevi i vostri messaggi. Undetectable AI Può aiutarvi:
- Fate apparire la vostra scrittura assistita dall'intelligenza artificiale simile all'uomo.
- Bypass tutti i principali strumenti di rilevamento dell'intelligenza artificiale con un solo clic.
- Utilizzo AI in modo sicuro e con fiducia a scuola e al lavoro.
Ma perché L'addestramento del modello di intelligenza artificiale è importante? Ecco alcuni motivi:
- Personalizzazione: È possibile personalizzare il modello di IA per soddisfare i requisiti unici della propria azienda o del proprio progetto.
- Precisione migliorata: Un modello ben addestrato può aumentare l'accuratezza delle previsioni per migliorare il processo decisionale.
- Costo-efficacia: L'automazione dei processi con l'IA può ridurre i costi operativi e aumentare la produttività.
- Maggiore efficienza: L'intelligenza artificiale è in grado di leggere molti dati in modo molto rapido, il che significa che le operazioni possono essere molto più efficienti.
- Scalabilità: Man mano che l'azienda cresce, il modello di intelligenza artificiale può essere aggiornato e addestrato con nuovi dati per continuare a fornire buoni risultati.
So, while AI might sound complicated at first, it’s actually a good thing. This impressive tech does all the repetitive work so we can focus on more creative and strategic tasks.
It’s even argued that disoccupazione tecnologica itself is a myth since we’ve always made progress throughout history.
Just as the Industrial Revolution opened up new job opportunities, it’s fair to think that we expect AI to do the same.
Il processo di formazione dell'intelligenza artificiale passo dopo passo
Apprendimento Competenze AI è diventato un vantaggio. Viene utilizzato sempre più spesso in tutti i settori, quindi conoscerne il funzionamento può darvi un vantaggio nel vostro campo.
Knowing how to train an AI model allows you to control its functions. Let’s get into the in-depth AI training process.
Fase 1: raccolta dei dati
Il fondamento della formazione dell'IA si basa sui dati. La qualità dei dati raccolti influisce direttamente sull'accuratezza e sull'efficacia del modello di IA.
When training a model, you’ll need to be able to gather relevant data based on your project’s goals, regardless of whether they’re images, text, audio, or other formats.
Per garantire l'autenticità dei set di dati di immagini, strumenti come Rilevatore di immagini AI può aiutare a distinguere le immagini reali da quelle generate dall'intelligenza artificiale, migliorando l'affidabilità del modello.
Le modalità di raccolta dei dati dipendono anche dalla portata del progetto.
È possibile utilizzare diversi metodi di raccolta dei dati per adattarli alle varie attività:
- Inserimento manuale dei dati: Raccolta manuale dei dati attraverso sondaggi, moduli o osservazione diretta.
- Scraping del web: Estrarre i dati dai siti web utilizzando strumenti come un web scraper API per raccogliere dati strutturati in modo efficiente. Molti sviluppatori abbinano gli strumenti di scraping agli strumenti di migliori proxy per data center per evitare blocchi e mantenere le richieste veloci ed efficienti dal punto di vista dei costi. Per attività di scraping più grandi o più dinamiche, proxy rotanti può aiutare a distribuire le richieste su più IP, riducendo il rischio di rilevamento e migliorando l'affidabilità della raccolta dati. Per la raccolta di dati su larga scala o continua, alcuni team passano a proxy residenziali illimitati to maintain stable access without bandwidth constraints. Teams running geo-specific scraping or training data collection from regional sources also benefit from best proxies by Proxy-Seller, which offer residential, ISP, and datacenter options with city and ISP-level targeting across 22+ countries.
- API: Utilizzo delle interfacce di programmazione delle applicazioni per raccogliere dati da fonti esterne.
- Repository di dati: Utilizzo di set di dati preesistenti già disponibili in banche dati pubbliche.
Si tenga presente che la raccolta dei dati può presentare delle difficoltà, come la presenza di dati incompleti, la ricezione di voci doppie o addirittura di informazioni irrilevanti.
If you’re considering web scraping as part of your data pipeline, it’s worth exploring the Le migliori API per lo scraping del web available now — 2025 tools that help make data gathering more scalable and reliable, and these tools typically include a built-in server proxy che ruota gli indirizzi IP per evitare che lo scraper venga identificato e bloccato durante le operazioni di scraping dei dati. Disporre di dati di alta qualità è importante per il successo del vostro modello di IA.
Disporre di dati di alta qualità è importante per il successo del modello di IA.
Fase 2: Pulizia e pre-elaborazione dei dati
Once you’ve collected your relevant data, you can proceed to clean and preprocess it.
Pulizia dei dati rimuove le informazioni non necessarie e si occupa di errori, duplicati e valori mancanti. Questa fase è necessaria affinché i dati siano accurati, affidabili e pronti per l'analisi.
Nel frattempo, preelaborazione trasforma i dati puliti per renderli compatibili con l'algoritmo di intelligenza artificiale.
I dati pre-elaborati portano a migliori prestazioni del modello, a una maggiore accuratezza e a risultati più significativi.
I dati mal preparati possono introdurre rumore e distorsioni, con conseguenti conclusioni imprecise o inaffidabili. La pulizia e la pre-elaborazione dei dati aiutano i modelli a dare il meglio di sé.
Fase 3: Etichettatura dei dati
In questa fase successiva, i dati devono essere etichettati in modo che il modello di intelligenza artificiale possa comprenderli e imparare da essi.
Etichettatura dei dati è il processo che identifica e contrassegna i dati grezzi con etichette pertinenti che rendono i dati leggibili dalla macchina.
È possibile farlo attraverso l'etichettatura manuale o automatica:
- Etichettatura manuale: Noi (umani) etichettiamo i dati. Questo metodo richiede più tempo, ma può essere molto affidabile per compiti complessi. Utilizzando un società di annotazione dei dati aiuta a velocizzare l'etichettatura e l'annotazione dei dati su scala.
- Etichettatura automatizzata: AI models are used to label data based on the patterns they learned. When the models are confident, they can label data automatically. If they’re uncertain, they pass the data to humans for labeling.
L'obiettivo è creare un set di dati etichettati noto come “ground truth,” che serve come standard per l'addestramento del modello AI.
Fase 4: Aumento dei dati
Aumento dei dati espande il set di dati apportando piccole modifiche, come la rotazione o il capovolgimento delle immagini, per generare nuovi dati da quelli esistenti. Ciò contribuisce a creare insiemi di dati diversi per l'addestramento dei modelli di intelligenza artificiale.
By artificially increasing your dataset’s size and variety, data augmentation can make the AI model more robust.
Ciò consente al modello di intelligenza artificiale di gestire in modo più efficace gli scenari del mondo reale, anche quando i dati reali sono limitati.
Fase 5: Suddivisione del set di dati
Splitting your dataset is essential for evaluating how accurate the AI model is. Typically, you’ll divide your data into training and test sets.
Il set di formazione insegna il modello, mentre il set di prova valuta le sue prestazioni.
Sometimes, there’s also a third set called the set di convalida. Questo viene aggiunto per affinare il modello durante l'addestramento.
Diversi modi di suddividere il set di dati impediscono l'overfitting e assicurano che il modello possa gestire facilmente nuovi dati non visti.
Fase 6: Bilanciamento dei dati e attenuazione delle distorsioni
Evitare i pregiudizi è fondamentale quando si addestra un modello di intelligenza artificiale. Questo perché Pregiudizio dell'intelligenza artificiale può portare a decisioni ingiuste che influenzano negativamente determinati gruppi di persone.
Bilanciamento dei dati garantisce che il set di dati rappresenti in modo equo i diversi gruppi, evitando che il modello favorisca un risultato rispetto a un altro.
Per mitigare i pregiudizi dell'IA, è possibile utilizzare tecniche come:
- Sovracampionamento: Aumentare gli esempi di gruppi sottorappresentati.
- Sottocampionamento: Ridurre gli esempi di gruppi sovrarappresentati.
- Sintesi dei dati: Generazione di dati artificiali per i gruppi di minoranza.
Balancing your data helps create a fairer AI model that’s able to deliver unbiased results, making it more reliable.
Fase 7: Privacy e sicurezza dei dati
Più di otto utenti su dieci credono che il modo in cui un'azienda gestisce i loro dati personali rifletta anche il modo in cui tratta i clienti.
La privacy e la sicurezza dei dati creano fiducia mantenendo le informazioni personali al sicuro da occhi indiscreti.
Con una tale quantità di dati sensibili in circolazione, la protezione da violazioni e abusi è più importante che mai.
Quando le aziende prendono sul serio la privacy, dimostrano che ci tengono.
Assicuratevi che i dati utilizzati siano crittografati in modo da nascondere i dati personali e seguite sempre rigide norme di sicurezza per proteggerli da accessi non autorizzati.
In questo modo si garantisce che il processo di addestramento dell'IA avvenga in modo responsabile.
Passo 8: Regolazione degli iperparametri
Regolazione dell'iperparametro is the process of adjusting the settings that control your AI model’s structure and behavior.
Esempi di iperparametri sono i tassi di apprendimento, le dimensioni dei batch e il numero di strati di una rete neurale.
Manual tuning can give you better insight into how these settings affect the model, but it’s time-consuming. Automated methods like grid search can speed up the process.
The goal is to find the best combination of hyperparameters to optimize your model’s performance without overfitting or underfitting.
Fase 9: Valutazione e convalida del modello
Una volta che il modello è stato addestrato, si può finalmente valutare il suo rendimento. Valutazione del modello measures the model’s ability to generalize and make accurate predictions based on new data.
Questo può essere fatto tipicamente usando il set di test e si possono misurare le prestazioni con metriche come l'accuratezza e la precisione.
If you’re concerned about bias, you can further split the test data into groups, such as by gender or geographical location, so that the model performance stays fair across all groups.
È inoltre possibile utilizzare strumenti di intelligenza artificiale affidabili come AI non rilevabile nel processo di formazione per affinare e umanizzare Contenuti generati dall'intelligenza artificiale.
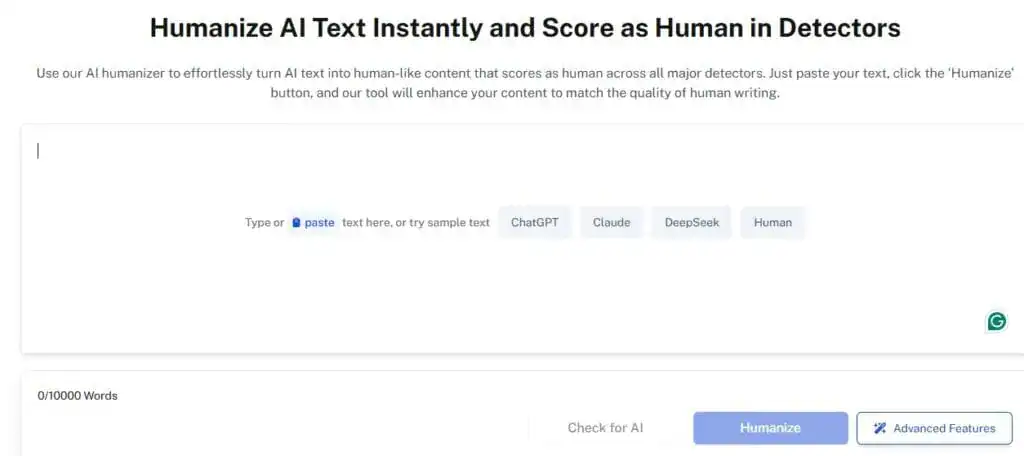
Undetectable può fare in modo che il contenuto generato venga letto in modo naturale ed eluda i più difficili strumenti di rilevamento dell'IA, rendendo il vostro modello ancora più efficace nelle applicazioni del mondo reale.
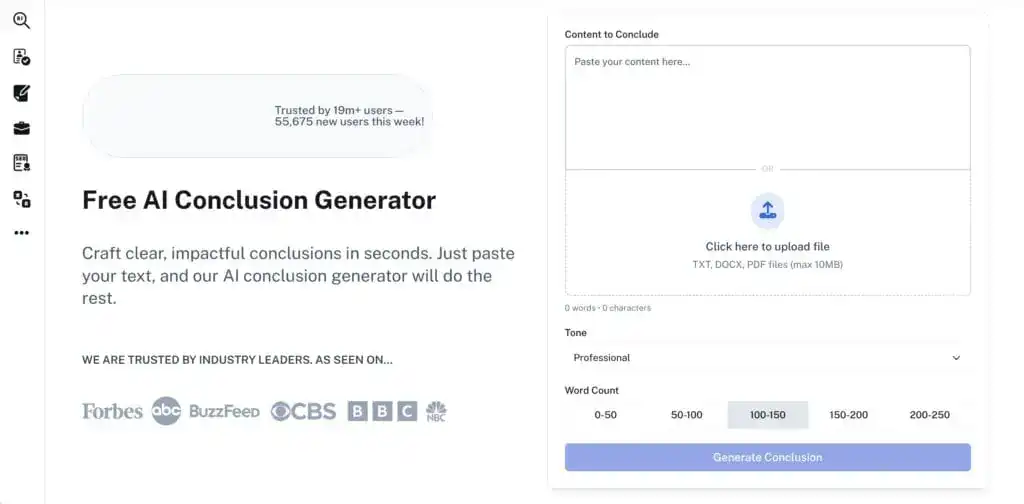
To see the real-world application of fine-tuning, you can observe how our Conclusion Generator demonstrates how AI models can be trained to produce structured and contextually relevant closing arguments.
This specific type of training ensures that the AI doesn’t just stop writing, but instead synthesizes complex data into a final, authoritative point that resonates with human readers.
Passo 10: Distribuzione e monitoraggio
La formazione del modello è solo metà del lavoro. La distribuzione integra il modello nei sistemi esistenti, dove gli utenti o le applicazioni possono accedervi. Questo è il vero banco di prova del vostro modello di intelligenza artificiale.
You’ll need to monitor your model post-deployment to ensure that it continues to deliver value. Issues like deriva dei dati può influire sulle sue prestazioni nel tempo.
Il monitoraggio costante consente di individuare tempestivamente questi problemi e di apportare le modifiche necessarie.
Strumenti che evidenziano le chiavi caratteristiche di AI-SPM (Gestione strategica delle prestazioni basata sull'intelligenza artificiale) aiutano a monitorare lo stato di salute del sistema, a ottimizzare il processo decisionale e ad allineare i risultati dei modelli con l'evoluzione degli obiettivi aziendali.
Undetectable AI can assist here as well by serving as your continuous AI-monitoring tool – even after deployment.
By doing this, your content stays high-quality and safe from AI detectors in real-world settings, maintaining your model’s effectiveness.
Il futuro della formazione AI
It’s exciting to see the possibilities of AI. As technology evolves even further, we can expect AI training methods to become more sophisticated.
Here’s what we can see the future of AI training holds:
- Raccolta dati automatizzata: L'intelligenza artificiale sarà in grado di gestire una parte maggiore della raccolta dei dati, riducendo il tempo e l'impegno necessari.
- Sviluppo etico dell'IA: L'enfasi sull'equità e sull'attenuazione dei pregiudizi diventerà uno standard nell'addestramento dell'IA.
- Apprendimento in tempo reale: I modelli di intelligenza artificiale impareranno e si adatteranno in movimento, rendendoli più reattivi alle nuove informazioni.
- Personalizzazione migliorata: L'intelligenza artificiale sarà in grado di personalizzare meglio le esperienze in base alle esigenze individuali.
The future is bright for AI. It’s already being used in vita quotidiana. Sebbene possa sembrare opprimente, la buona notizia è che questi progressi renderanno l'IA più potente e accessibile.
Le aziende che cercano di essere all'avanguardia in questo panorama in continua evoluzione possono trarre grandi vantaggi da un'attività professionale. Servizi di sviluppo AI.
Questi servizi si concentrano sul miglioramento delle modalità di apprendimento dell'IA, aprendo la strada a applicazioni e possibilità rivoluzionarie.
Sfide comuni nell'addestramento dell'IA (e come superarle)
L'addestramento di un modello di IA non è sempre facile.
Anche con le giuste misure in atto, i principianti spesso devono affrontare problemi che influiscono sulla precisione, la velocità e l'affidabilità.
One of the most common challenges is dealing with low-quality or inconsistent data, which can lead to inaccurate predictions. This often happens when web scrapers get blocked by security filters, which is why developers rely on residential proxies to ensure uninterrupted access to accurate data.
Alcuni modelli presentano anche un overfitting, ovvero funzionano bene durante l'addestramento ma falliscono quando vengono esposti a nuove informazioni. Le limitazioni hardware possono rallentare l'addestramento, specialmente per i modelli che richiedono molte risorse.
La distorsione nei set di dati è un altro problema importante, che spesso causa risultati ingiusti o distorti. Il modo migliore per gestire questi problemi è utilizzare dati puliti e bilanciati, effettuare validazioni regolari e apportare continue modifiche dopo l'implementazione.
Strumenti come AI non rilevabile può anche aiutare a perfezionare i contenuti generati dall'IA durante l'addestramento, in modo che il modello apprenda da esempi più naturali e di qualità umana.
Provate subito l'Undetectable AI Widget! È incredibilmente semplice: basta copiare il testo e fare clic sul pulsante per umanizzarlo.
Conclusione
Learning how to train AI might seem complex, but breaking it down really shows that it’s quite manageable – and the payoff is undeniable.
Ogni fase presa con attenzione può avere un ruolo cruciale nel definire quanto potente ed efficace possa essere il vostro modello di IA.
Remember to integrate Undetectable AI into your training process so that it can improve your model’s performance (especially in the later stages).
Essere in grado di perfezionare i contenuti generati dall'intelligenza artificiale di aggirare gli strumenti di rilevamento e di leggere in modo più naturale, lo farà funzionare meglio nelle applicazioni reali, soprattutto per la creazione di contenuti.