Wouldn’t it be nice to have a Chatbot for your business? Something that runs round-the-clock on your website so you don’t miss possible customers in the wee hours of the night?
Ein Bericht aus dem Jahr 2025 ergab, dass Nachtschwärmer die höchsten Einnahmen generieren, obwohl sie nur einen kleinen Teil des gesamten Browsing-Verkehrs ausmachen, was zeigt, wie wertvoll der nächtliche Traffic sein kann.
Well, it’s time to learn how to train AI. With the right training, your personalized AI model will be able to analyze customer data, predict what you need, and give fast and accurate responses.
But this isn’t just for businesses to take advantage of. AI has made an Auswirkungen auf die Arbeitsplätze durch den Einsatz von maschinellem Lernen zur Rationalisierung von Aufgaben und zur Verbesserung der Entscheidungsfindung anhand zuverlässiger Daten.
Whether you’re a business owner looking to improve your operations or a researcher who wants to push the limits of today’s tech, knowing how AI works is definitely beneficial.
Here’s our guide on how to train an AI model to make it your powerful asset.
Lasst uns eintauchen!
Wichtigste Erkenntnisse
-
Das Training eines KI-Modells umfasst die Einspeisung großer, hochwertiger Datensätze, damit es Muster lernen, Vorhersagen treffen und seine Genauigkeit im Laufe der Zeit verbessern kann.
-
Der Prozess umfasst mehrere wichtige Phasen: Datenerfassung, Bereinigung, Kennzeichnung, Erweiterung, Aufteilung, Abgleich, Datenschutz, Optimierung, Bewertung und Bereitstellung.
-
Saubere, unvoreingenommene und sichere Daten sind entscheidend, um faire und zuverlässige KI-Modelle zu gewährleisten, die in realen Anwendungen präzise funktionieren können.
-
Eine kontinuierliche Überwachung nach der Bereitstellung verhindert Datenabweichungen und Leistungseinbußen und sorgt dafür, dass Ihr Modell effizient und zuverlässig bleibt.
-
Tools wie Undetectable AI können KI-generierte Inhalte während des gesamten Trainingsprozesses verfeinern und humanisieren, um sicherzustellen, dass die Ergebnisse natürlich, ethisch und für den Einsatz in der Praxis geeignet sind.
Was ist KI-Training, und warum ist es wichtig?
KI-Training ist genau das, wonach es sich anhört - der Prozess des Trainings eines maschinellen Lernmodells. Mit Ihrer Hilfe kann es lernen, Muster zu erkennen, Vorhersagen zu treffen oder bestimmte Aufgaben auszuführen.
Beim Training wird das KI-System mit einer großen Menge an relevanten Daten gefüttert. Das Modell analysiert diese Daten und lernt daraus. Wir können dann erwarten, dass sich seine Leistung mit der Zeit verbessert.
The better the quality of data that’s used during training, the more accurate and effective the AI model will be.
Machen Sie sich nie wieder Sorgen, dass KI Ihre Texte erkennt. Undetectable AI Kann Ihnen helfen:
- Lassen Sie Ihr AI-unterstütztes Schreiben erscheinen menschenähnlich.
- Bypass alle wichtigen KI-Erkennungstools mit nur einem Klick.
- Verwenden Sie AI sicher und zuversichtlich in Schule und Beruf.
Aber warum ist das Training Ihres KI-Modells wichtig? Hier sind einige Gründe:
- Anpassungen: Sie können das KI-Modell an die speziellen Anforderungen Ihres Unternehmens oder Projekts anpassen.
- Verbesserte Genauigkeit: Ein gut trainiertes Modell kann die Vorhersagegenauigkeit erhöhen und damit die Entscheidungsfindung verbessern.
- Kosten-Nutzen-Verhältnis: Die Automatisierung von Prozessen mit KI kann die Betriebskosten senken und die Produktivität steigern.
- Gesteigerte Effizienz: KI kann viele Daten sehr schnell lesen, was bedeutet, dass Ihre Abläufe viel effizienter sein können.
- Skalierbarkeit: Wenn Ihr Unternehmen wächst, kann Ihr KI-Modell auch aktualisiert und mit neuen Daten trainiert werden, um weiterhin gute Ergebnisse zu liefern.
So, while AI might sound complicated at first, it’s actually a good thing. This impressive tech does all the repetitive work so we can focus on more creative and strategic tasks.
It’s even argued that technologische Arbeitslosigkeit itself is a myth since we’ve always made progress throughout history.
Just as the Industrial Revolution opened up new job opportunities, it’s fair to think that we expect AI to do the same.
Der AI-Trainingsprozess - Schritt für Schritt
Lernen KI-Fähigkeiten hat sich zu einem echten Vorteil entwickelt. Sie wird in immer mehr Branchen eingesetzt. Wenn Sie also wissen, wie sie funktioniert, können Sie sich in Ihrem Bereich einen Vorteil verschaffen.
Knowing how to train an AI model allows you to control its functions. Let’s get into the in-depth AI training process.
Schritt 1: Datenerhebung
Die Grundlage für das KI-Training sind die Daten. Die Qualität der Daten, die Sie sammeln, hat direkten Einfluss darauf, wie genau und effektiv Ihr KI-Modell sein wird.
When training a model, you’ll need to be able to gather relevant data based on your project’s goals, regardless of whether they’re images, text, audio, or other formats.
Um die Authentizität von Bilddatensätzen sicherzustellen, werden Tools wie AI-Bild-Detektor kann dabei helfen, zwischen echtem und KI-generiertem Bildmaterial zu unterscheiden und die Zuverlässigkeit Ihres Modells zu verbessern.
Wie Sie Daten sammeln, hängt auch vom Umfang Ihres Projekts ab.
Je nach Aufgabenstellung können unterschiedliche Methoden der Datenerhebung eingesetzt werden:
- Manuelle Dateneingabe: Manuelle Datenerfassung durch Umfragen, Formulare oder direkte Beobachtung.
- Web-Scraping: Extrahieren von Daten aus Websites mithilfe von Tools wie einem Web Scraper API um strukturierte Daten effizient zu sammeln. Viele Entwickler kombinieren Scraping-Tools mit dem Beste Proxys für Rechenzentren um Blockierungen zu vermeiden und die Anfragen schnell und kostengünstig zu halten. Für größere oder dynamischere Scraping-Aufgaben, Drehbevollmächtigte kann helfen, Anfragen auf mehrere IPs zu verteilen, wodurch das Entdeckungsrisiko verringert und die Zuverlässigkeit der Datenerfassung verbessert wird. Für groß angelegte oder kontinuierliche Datenerhebungen wechseln einige Teams zu unbegrenzte Proxys für Privathaushalte to maintain stable access without bandwidth constraints. Teams running geo-specific scraping or training data collection from regional sources also benefit from best proxies by Proxy-Seller, which offer residential, ISP, and datacenter options with city and ISP-level targeting across 22+ countries.
- APIs: Verwendung von Anwendungsprogrammierschnittstellen zur Erfassung von Daten aus externen Quellen.
- Daten-Repositories: Nutzung bereits vorhandener Datensätze, die bereits in öffentlichen Datenbanken verfügbar sind.
Seien Sie sich jedoch bewusst, dass die Datenerfassung ihre eigenen Probleme mit sich bringen kann, z. B. unvollständige Daten, doppelte Einträge oder sogar irrelevante Informationen.
If you’re considering web scraping as part of your data pipeline, it’s worth exploring the beste Web Scraping APIs available now — 2025 tools that help make data gathering more scalable and reliable, and these tools typically include a built-in Proxyserver System, das IP-Adressen rotieren lässt, um zu verhindern, dass der Scraper während des Daten-Scraping-Vorgangs identifiziert und blockiert wird. Hochwertige Daten sind wichtig für den Erfolg Ihres KI-Modells.
Hochwertige Daten sind wichtig für den Erfolg Ihres KI-Modells.
Schritt 2: Datenbereinigung und Vorverarbeitung
Once you’ve collected your relevant data, you can proceed to clean and preprocess it.
Datenbereinigung entfernt unnötige Informationen und behandelt Fehler, Duplikate und fehlende Werte. Dieser Schritt ist notwendig, damit Ihre Daten genau, zuverlässig und für die Analyse bereit sind.
Inzwischen, Vorverarbeitung wandelt die bereinigten Daten so um, dass sie mit dem KI-Algorithmus kompatibel sind.
Vorverarbeitete Daten führen zu einer besseren Modellleistung, höherer Genauigkeit und aussagekräftigeren Ergebnissen.
Schlecht aufbereitete Daten können Rauschen und Verzerrungen verursachen, die zu ungenauen oder unzuverlässigen Schlussfolgerungen führen. Die Bereinigung und Vorverarbeitung Ihrer Daten trägt dazu bei, dass die Modelle ihr Bestes geben können.
Schritt 3: Datenbeschriftung
In diesem nächsten Schritt müssen die Daten beschriftet werden, damit das KI-Modell sie verstehen und daraus lernen kann.
Kennzeichnung der Daten ist der Prozess, der Rohdaten identifiziert und mit relevanten Etiketten versieht, die die Daten maschinenlesbar machen.
Sie können dies durch manuelle oder automatische Etikettierung erreichen:
- Manuelle Beschriftung: Wir (Menschen) beschriften die Daten. Diese Methode ist zeitaufwändiger, kann aber bei komplexen Aufgaben sehr zuverlässig sein. Die Verwendung einer Datenverarbeitungsunternehmen trägt dazu bei, die Datenbeschriftung und -kommentierung in großem Umfang zu beschleunigen.
- Automatisierte Etikettierung: AI models are used to label data based on the patterns they learned. When the models are confident, they can label data automatically. If they’re uncertain, they pass the data to humans for labeling.
Das Ziel ist es, einen beschrifteten Datensatz zu erstellen, der als “ground truth,” die als Standard für das Training des KI-Modells dient.
Schritt 4: Datenerweiterung
Datenerweiterung erweitert Ihren Datensatz durch kleine Änderungen wie das Drehen oder Spiegeln von Bildern, um neue Daten aus vorhandenen Daten zu generieren. Auf diese Weise können Sie verschiedene Datensätze für das Training von KI-Modellen erstellen.
By artificially increasing your dataset’s size and variety, data augmentation can make the AI model more robust.
So kann Ihr KI-Modell reale Szenarien besser bewältigen, auch wenn die tatsächlichen Daten begrenzt sind.
Schritt 5: Aufteilung des Datensatzes
Splitting your dataset is essential for evaluating how accurate the AI model is. Typically, you’ll divide your data into training and test sets.
Die Trainingsset lehrt das Modell, während die Testsatz bewertet seine Leistung.
Sometimes, there’s also a third set called the Validierungssatz. Dies dient der Feinabstimmung des Modells während des Trainings.
Verschiedene Möglichkeiten, den Datensatz aufzuteilen, verhindern eine Überanpassung und stellen sicher, dass das Modell neue, ungesehene Daten mühelos verarbeiten kann.
Schritt 6: Datenabgleich und Abschwächung von Verzerrungen
Die Vermeidung von Verzerrungen ist beim Training eines KI-Modells von entscheidender Bedeutung. Der Grund dafür ist KI-Voreingenommenheit kann zu unfairen Entscheidungen führen, die bestimmte Personengruppen benachteiligen.
Datenausgleich stellt sicher, dass Ihr Datensatz die verschiedenen Gruppen fair repräsentiert, und dies kann verhindern, dass Ihr Modell ein Ergebnis gegenüber einem anderen bevorzugt.
Um KI-Verzerrungen abzuschwächen, können Sie Techniken wie diese anwenden:
- Oversampling: Immer mehr Beispiele aus unterrepräsentierten Gruppen.
- Undersampling: Reduzierung von Beispielen aus überrepräsentierten Gruppen.
- Daten-Synthese: Generierung künstlicher Daten für Minderheitengruppen.
Balancing your data helps create a fairer AI model that’s able to deliver unbiased results, making it more reliable.
Schritt 7: Datenschutz und Datensicherheit
Mehr als acht von zehn Nutzern sind der Meinung, dass die Art und Weise, wie ein Unternehmen mit ihren persönlichen Daten umgeht, auch zeigt, wie es seine Kunden behandelt.
Datenschutz und Datensicherheit schaffen Vertrauen, indem sie persönliche Informationen vor neugierigen Blicken schützen.
Angesichts der großen Menge an sensiblen Daten ist es wichtiger denn je, diese vor Verstößen und Missbrauch zu schützen.
Wenn Unternehmen den Datenschutz ernst nehmen, zeigt das, dass sie sich Gedanken machen.
Vergewissern Sie sich, dass die von Ihnen verwendeten Daten verschlüsselt sind, so dass persönliche Angaben verborgen bleiben, und befolgen Sie stets strenge Sicherheitsvorschriften, um sie vor unbefugtem Zugriff zu schützen.
Auf diese Weise stellen Sie sicher, dass der KI-Trainingsprozess verantwortungsvoll durchgeführt wird.
Schritt 8: Abstimmung der Hyperparameter
Abstimmung der Hyperparameter is the process of adjusting the settings that control your AI model’s structure and behavior.
Beispiele für Hyperparameter sind Lernraten, Stapelgrößen und die Anzahl der Schichten in einem neuronalen Netz.
Manual tuning can give you better insight into how these settings affect the model, but it’s time-consuming. Automated methods like grid search can speed up the process.
The goal is to find the best combination of hyperparameters to optimize your model’s performance without overfitting or underfitting.
Schritt 9: Modellbewertung und -validierung
Sobald Ihr Modell trainiert ist, können Sie schließlich bewerten, wie gut es funktioniert. Bewertung des Modells measures the model’s ability to generalize and make accurate predictions based on new data.
Dies kann in der Regel mit dem Testsatz geschehen, und Sie können die Leistung mit Metriken wie Genauigkeit und Präzision messen.
If you’re concerned about bias, you can further split the test data into groups, such as by gender or geographical location, so that the model performance stays fair across all groups.
Sie können auch zuverlässige KI-Tools verwenden wie Nicht nachweisbare AI im Ausbildungsprozess zur Verfeinerung und vermenschlichen KI-generierte Inhalte.
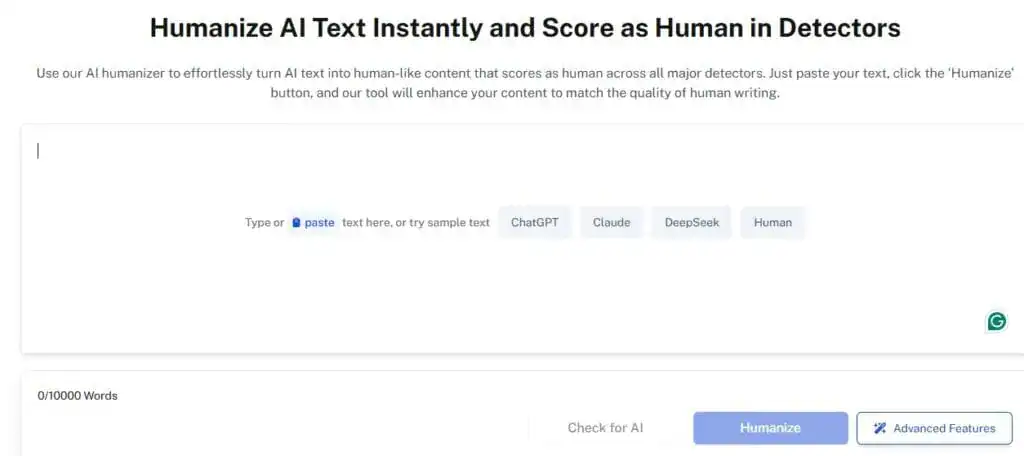
Undetectable kann sicherstellen, dass die generierten Inhalte sich natürlich lesen und die härtesten KI-Erkennungstools umgehen, wodurch Ihr Modell in realen Anwendungen noch effektiver wird.
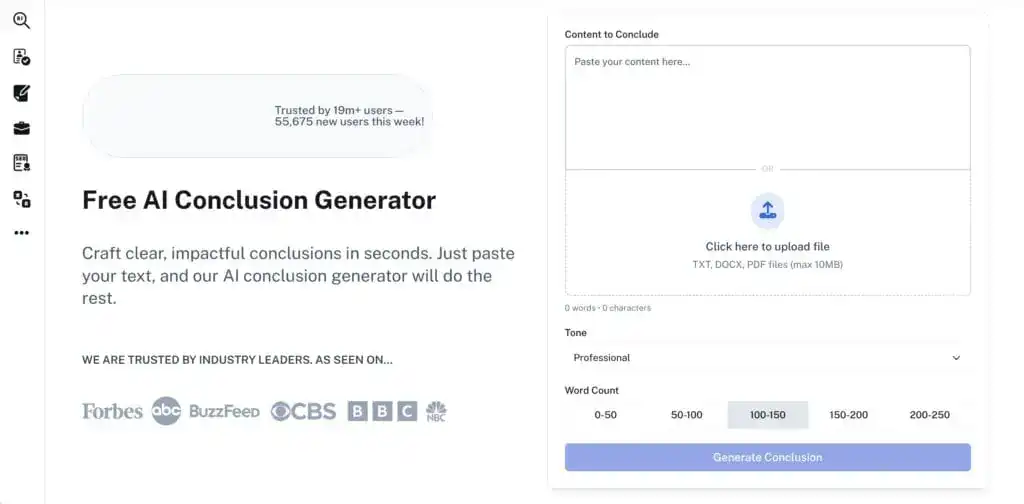
To see the real-world application of fine-tuning, you can observe how our Conclusion Generator demonstrates how AI models can be trained to produce structured and contextually relevant closing arguments.
This specific type of training ensures that the AI doesn’t just stop writing, but instead synthesizes complex data into a final, authoritative point that resonates with human readers.
Schritt 10: Einsatz und Überwachung
Die Schulung Ihres Modells ist nur die Hälfte der Arbeit. Bei der Bereitstellung wird das Modell in bestehende Systeme integriert, wo Benutzer oder Anwendungen darauf zugreifen können. Dies ist der eigentliche Test für Ihr KI-Modell.
You’ll need to monitor your model post-deployment to ensure that it continues to deliver value. Issues like Datendrift kann seine Leistung im Laufe der Zeit beeinträchtigen.
Durch eine ständige Überwachung können Sie diese Probleme frühzeitig erkennen und die notwendigen Anpassungen vornehmen.
Tools zur Hervorhebung wichtiger Merkmale von AI-SPM (KI-basiertes strategisches Leistungsmanagement) helfen dabei, den Zustand des Systems zu verfolgen, die Entscheidungsfindung zu optimieren und die Modellergebnisse mit den sich entwickelnden Geschäftszielen abzustimmen.
Undetectable AI can assist here as well by serving as your continuous AI-monitoring tool – even after deployment.
By doing this, your content stays high-quality and safe from AI detectors in real-world settings, maintaining your model’s effectiveness.
Die Zukunft der KI-Schulung
It’s exciting to see the possibilities of AI. As technology evolves even further, we can expect AI training methods to become more sophisticated.
Here’s what we can see the future of AI training holds:
- Automatisierte Datenerfassung: Die KI wird einen größeren Teil der Datenerfassung übernehmen können, was den Zeit- und Arbeitsaufwand verringert.
- Ethische KI-Entwicklung: Die Betonung von Fairness und die Abschwächung von Vorurteilen werden zum Standard beim KI-Training.
- Lernen in Echtzeit: KI-Modelle werden unterwegs lernen und sich anpassen, so dass sie besser auf neue Informationen reagieren können.
- Verbesserte Personalisierung: KI wird besser in der Lage sein, Erlebnisse auf die individuellen Bedürfnisse zuzuschneiden.
The future is bright for AI. It’s already being used in Alltagsleben. Auch wenn es sich überwältigend anfühlt, ist die gute Nachricht, dass diese Fortschritte die KI leistungsfähiger und zugänglicher machen.
Unternehmen, die in dieser sich wandelnden Landschaft die Nase vorn haben wollen, können von professionellen AI-Entwicklungsdienstleistungen.
Diese Dienste konzentrieren sich darauf, die Lernfähigkeit von KI zu verbessern und damit den Weg für bahnbrechende Anwendungen und Möglichkeiten zu ebnen.
Häufige Herausforderungen beim Training von KI (und wie man sie bewältigt)
Das Trainieren eines KI-Modells verläuft nicht immer reibungslos.
Selbst wenn die richtigen Maßnahmen getroffen werden, stehen Anfänger oft vor Problemen, die sich auf Genauigkeit, Geschwindigkeit und Zuverlässigkeit auswirken.
One of the most common challenges is dealing with low-quality or inconsistent data, which can lead to inaccurate predictions. This often happens when web scrapers get blocked by security filters, which is why developers rely on residential proxies to ensure uninterrupted access to accurate data.
Einige Modelle sind auch überangepasst, was bedeutet, dass sie während des Trainings gut funktionieren, aber versagen, wenn sie mit neuen Informationen konfrontiert werden. Hardwarebeschränkungen können das Training verlangsamen, insbesondere bei ressourcenintensiven Modellen.
Verzerrungen in Datensätzen sind ein weiteres großes Problem, das oft zu unfairen oder verzerrten Ergebnissen führt. Der beste Weg, um diese Probleme zu lösen, sind saubere, ausgewogene Daten, regelmäßige Validierungen und fortlaufende Anpassungen nach der Bereitstellung.
Tools wie Nicht nachweisbare AI kann auch dazu beitragen, KI-generierte Inhalte während des Trainings zu verfeinern, sodass Ihr Modell aus natürlicheren Beispielen in menschlicher Qualität lernt.
Testen Sie das Unerkennbare KI-Widget jetzt! Es ist unglaublich einfach - kopieren Sie einfach Ihren Text und klicken Sie auf die Schaltfläche, um ihn zu vermenschlichen.
Schlussfolgerung
Learning how to train AI might seem complex, but breaking it down really shows that it’s quite manageable – and the payoff is undeniable.
Jede Phase, die Sie sorgfältig durchlaufen, kann entscheidend dazu beitragen, wie leistungsfähig und effektiv Ihr KI-Modell sein kann.
Remember to integrate Undetectable AI into your training process so that it can improve your model’s performance (especially in the later stages).
In der Lage zu sein Verfeinern Sie Ihre KI-generierten Inhalte Die Möglichkeit, Erkennungswerkzeuge zu umgehen und natürlicher zu lesen, wird in der Praxis besser funktionieren, insbesondere bei der Erstellung von Inhalten.